<?xml version="1.0" encoding="utf-8"?><html xml:lang="ja" xmlns="http://www.w3.org/1999/html" xmlns:epub="http://www.idpf.org/2007/opf">
    <head>
        <meta name="viewport" content="target-densitydpi=device-dpi, width=device-width, maximum-scale=1.0, user-scalable=yes" />
<meta charset="UTF-8"/>
        
        <meta content="book3" name="CAS-UB-Publication-Class"/>
        <meta content="CAS-UB Backend System Installed on 2013-11-27" name="Generator-Signature"/>
        <title>小特集 1. データセンターネットワークの最新動向</title>
        <link href="themes/cas-common_epub.css" rel="stylesheet" type="text/css"/>
        <link href="themes/plain2/common.css" rel="stylesheet" type="text/css"/>
        <link href="styles/style.css" rel="stylesheet" type="text/css"/>
<script>
  (function(i,s,o,g,r,a,m){i['GoogleAnalyticsObject']=r;i[r]=i[r]||function(){
  (i[r].q=i[r].q||[]).push(arguments)},i[r].l=1*new Date();a=s.createElement(o),
  m=s.getElementsByTagName(o)[0];a.async=1;a.src=g;m.parentNode.insertBefore(a,m)
  })(window,document,'script','https://www.google-analytics.com/analytics.js','ga');

  ga('create', 'UA-88485500-1', 'auto');
  ga('send', 'pageview');

</script>
        </head>
    <body style="-webkit-text-size-adjust: 100%;" class="wrapper chapter level2" id="e_2e0000_2e_E5_B0_8F_E7_89_B9_E9_9B_86_201_2e_20_E3_83_87_E3_83_BC_E3_82_BF_E3_82_BB_E3_83_B3_E3_82_BF_E3_83_BC_E3_83_8D_E3_83_83_E3_83_88_E3_83_AF_E3_83_BC_E3_82_AF_E3_81_AE_E6_9C_80_E6_96_B0_E5_8B_95_E5_90_91"><h1 class="sys-hidden" style="display:none">小特集 1. データセンターネットワークの最新動向</h1>
<div class="header">
<table class="header-in" align="center" valign="middle">
<tr>
<td class="left-table">
<a class="" href="https://www.ieice.org/jpn/"><img class="ieice-logo" src="../../img/logo.png" /></a>
</td>
<td class="right-table" align="center">
<a href="../../index.html" class="top_link" align="center"><b align="center">電子情報通信学会 - IEICE会誌 試し読みサイト</b></a>
<div class="copyright">© Copyright IEICE. All rights reserved.</div>
</td>
</tr>
</table></div>
<div class="header-border"></div>
<div class="contents">
<div class="contents-in">
<form name="number_post" method="POST" action="../../index.php">
<input type="hidden" name="index-page" value="106_2" />
</form>
<a href="javascript:document.number_post.submit()" class="index-number-link" style="float: right;">Vol.106 No.2 (2023/2)　目次へ</a><br /><br />
<div class="article-navigation"><a href="../k106_2_97/index.html" style="float: left;">前の記事へ</a><a href="../k106_2_106/index.html" style="float: right;">次の記事へ</a></div><br /><br />


<p class="margin-bottom-2em date left9em gray">データセンターネットワークの<span class="gext not-separates">最新動向</span></p>
<p class="head-toku"><span class="gext near-ayame-iro">小特集</span> <span class="gext usuzumiiro">1.</span></p>
<p class="title-ja">データセンターネットワークの最新動向</p>
<p class="title-en">Recent Trends for Datacenter Networks</p>
<p class="title_author">高橋　亮</p>
<div class="gext author_detail5"><p class="li-1em">高橋　亮　正員：シニア会員　国立研究開発法人情報通信研究機構ネットワーク研究所</p>

<p>Ryo TAKAHASHI, Senior Member (Network Research Institute, National Institute of Information and Communications Technology, Koganei-shi, 184-8795 Japan).</p>
<p>電子情報通信学会誌　Vol.106 No.2 pp.98-105 2023年2月</p>
<p>©電子情報通信学会2023</p>
</div>
<div class="gext abstract"><p><em><strong class="near-ayame-iro font2em en">Abstract</strong></em></p>
<p>　Society5.0の中核技術であるCyber-Physical Systemの実現には，エッジ／クラウドコンピューティングでの情報処理能力を飛躍的に向上させる必要がある．それに向けてデータセンターでは，AI/HPC（高性能コンピューティング）を中心とするシステムへの移行を進めており，これまでにない大きな変革を迎えようとしている．本稿では，データセンターネットワーク，光インタコネクション技術，コンピューティングアーキテクチャの観点から，最近の研究開発動向を鳥瞰する．</p>
<p><strong class="m-gothic">キーワード</strong>：データセンター，エッジコンピューティング，光インタコネクション，コンピューティングアーキテクチャ</p>
</div>
<div class="wrapper level3" id="h_2e0000_2e1_EF_BC_8E_E3_81_AF_E3_80_80_E3_81_98_E3_80_80_E3_82_81_E3_80_80_E3_81_AB"><h1>1．は　じ　め　に</h1>
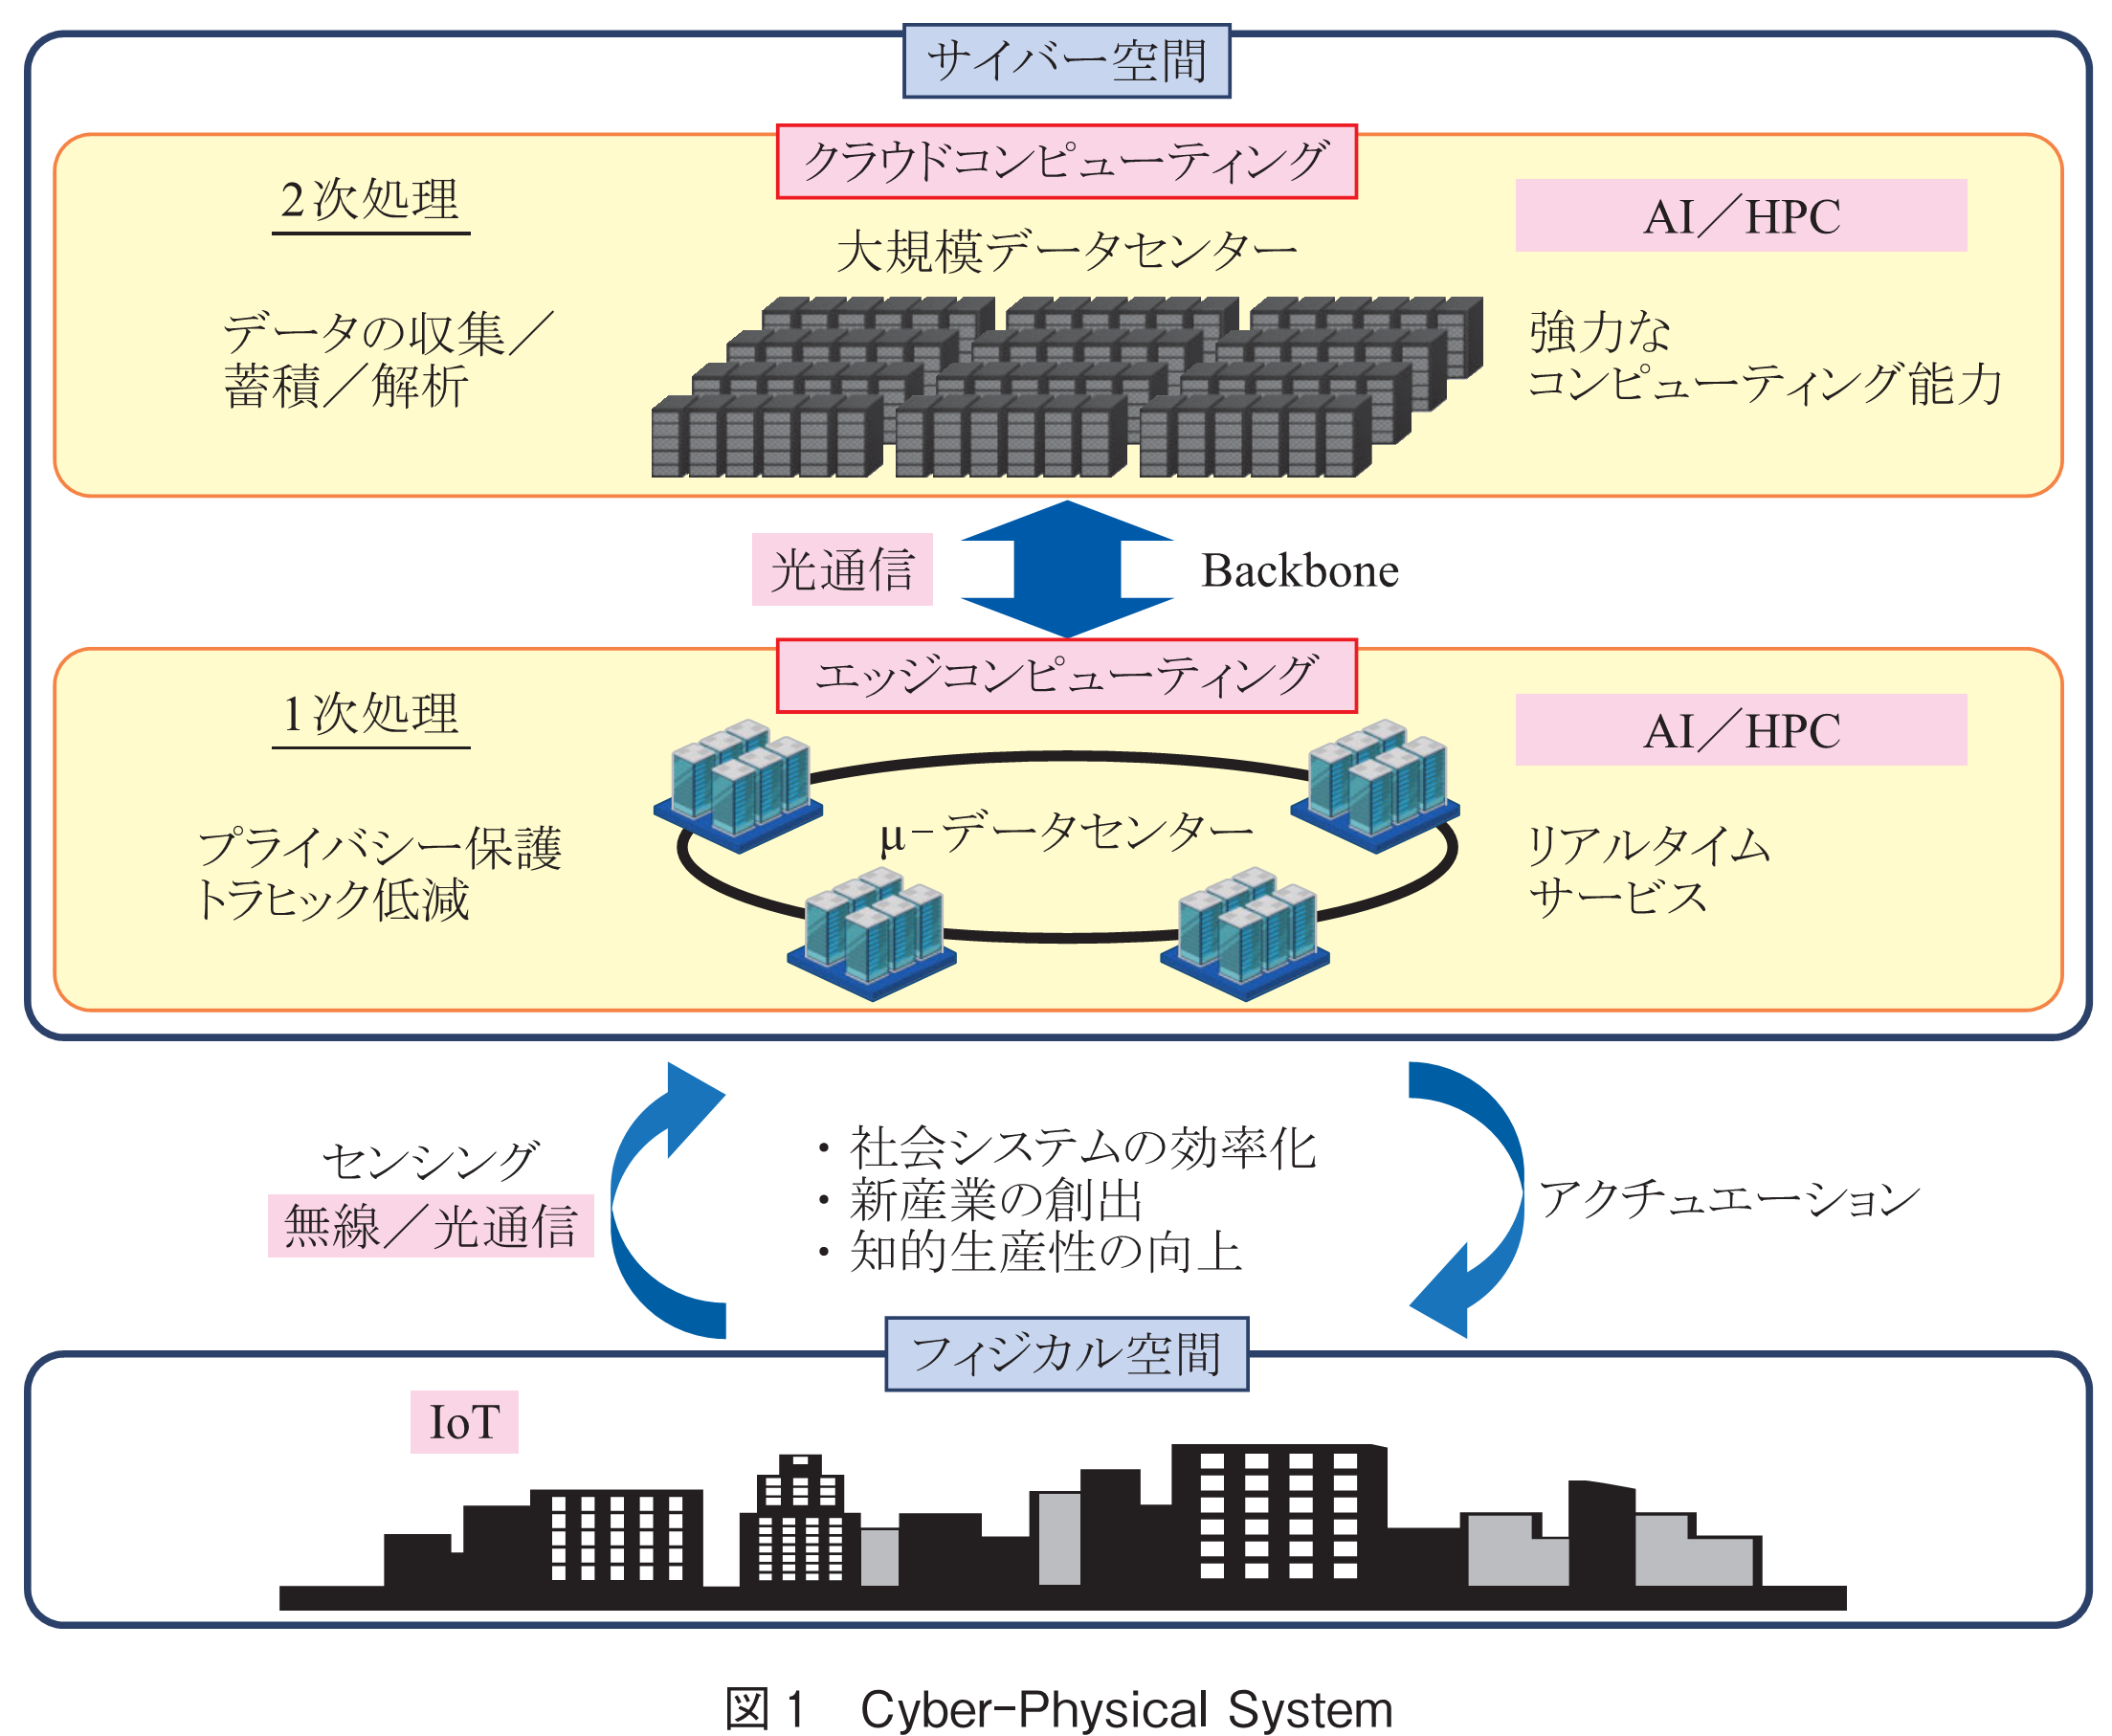
<p>　内閣府が提唱するSociety5.0（超スマート社会)<a href="#u_2e0000_2eref01"><sup>(1)</sup></a>の実現には，サイバー空間とフィジカル空間を高度に融合させたCPS（Cyber-Physical System）が不可欠である（<a href="index.html#u_2e0000_2efig-1">図1</a>）．CPSの実現には，フィジカル空間でのIoT技術や，フィジカル空間とサイバー空間とを連結する大容量データ転送技術（無線通信，光通信）とともに，サイバー空間での情報処理能力の大幅な向上が重要である．これまでフィジカル空間のデータは，郊外の大規模データセンター（Datacenter：以降DC）に送られ処理されてきたが，距離に起因して伝搬遅延が大きくなり，自動運転等のリアルタイムサービスへの対応が困難である．そのため近年では，メトロ網周辺に小形のDC（<span class="gext img" id="math_i1"><img alt="math" src="images/math_i1.svg"/></span>-DC，エッジDC，small DC等と呼ばれる）を分散配置したエッジコンピューティングの構築が進められている．</p>
<div id="u_2e0000_2efig-1"><div class="gext fig" id="fig_1"><p><img alt="図1　Cyber-Physical System" src="images/fig_1.png"/></p>
</div>
</div>
<p>　これらサイバー空間の中核を担うDCでは，従来光トランシーバやスイッチ装置，サーバ等の要素技術の高度化に支えられ発展してきた．しかし近年，DCトラヒックの爆発的増加に対し，これら要素技術の成長に遅れが生じ（Growth Gap），様々な面でひずみが生じてきた．例えば，ネットワークの領域では，DCトラヒックの増加＞スイッチ装置の容量増加＞スイッチ間リンク容量の増加により，光トランシーバの性能がDCネットワークの性能を律速している．更に，サーバの領域では，AIパラメータの増加＞プロセッサ等の性能向上＞メモリ帯域幅の増加（Memory Wall）により，同様にデータ転送性能が情報処理能力の向上に大きな制約を与えている．</p>
<p>　これらの問題を解決するため，近年DCでは様々な破壊的変革を迎えようとしている．ネットワーク領域では，ネットワークアーキテクチャや光インタコネクション技術の変革が進められており，サーバ領域ではAI/HPC（High-performance Computing）を中心とした高度システム構築に向けて，コンピューティングアーキテクチャの大きな変革が検討されている．本稿では，このようなDCが直面する様々な変革に対し，ネットワーク／インタコネクション（ハードウェア）の観点から最近の研究開発動向を概説する．</p>
<p class="line-gap"> </p>
</div>
<div class="wrapper level3" id="h_2e0000_2e2_EF_BC_8E_E3_83_87_E3_83_BC_E3_82_BF_E3_82_BB_E3_83_B3_E3_82_BF_E3_83_BC_E3_83_8D_E3_83_83_E3_83_88_E3_83_AF_E3_83_BC_E3_82_AF"><h1>2．データセンターネットワーク</h1>
<p>　DCは，元々企業のサーバ室や大型計算機室に存在したが，1990年代に入り様々なインターネットサービスが商用化され，多くの専用事業者によるDCが誕生した．2000年代に入ると，サーバ仮想化技術（1台のサーバで複数の仮想マシンの稼動が可能）や仮想マシンマイグレーション技術（任意のサーバへの仮想マシンの移動が可能）が誕生し，マルチコアサーバの性能が最大限活用可能になるとともに，DCネットワークのトラヒックが大幅に増大した．更に2010年代に入ると，ネットワーク仮想化及びDC仮想化が進展し，DC間が連動することにより，クラウドコンピューティングが本格的に稼動することとなる．</p>
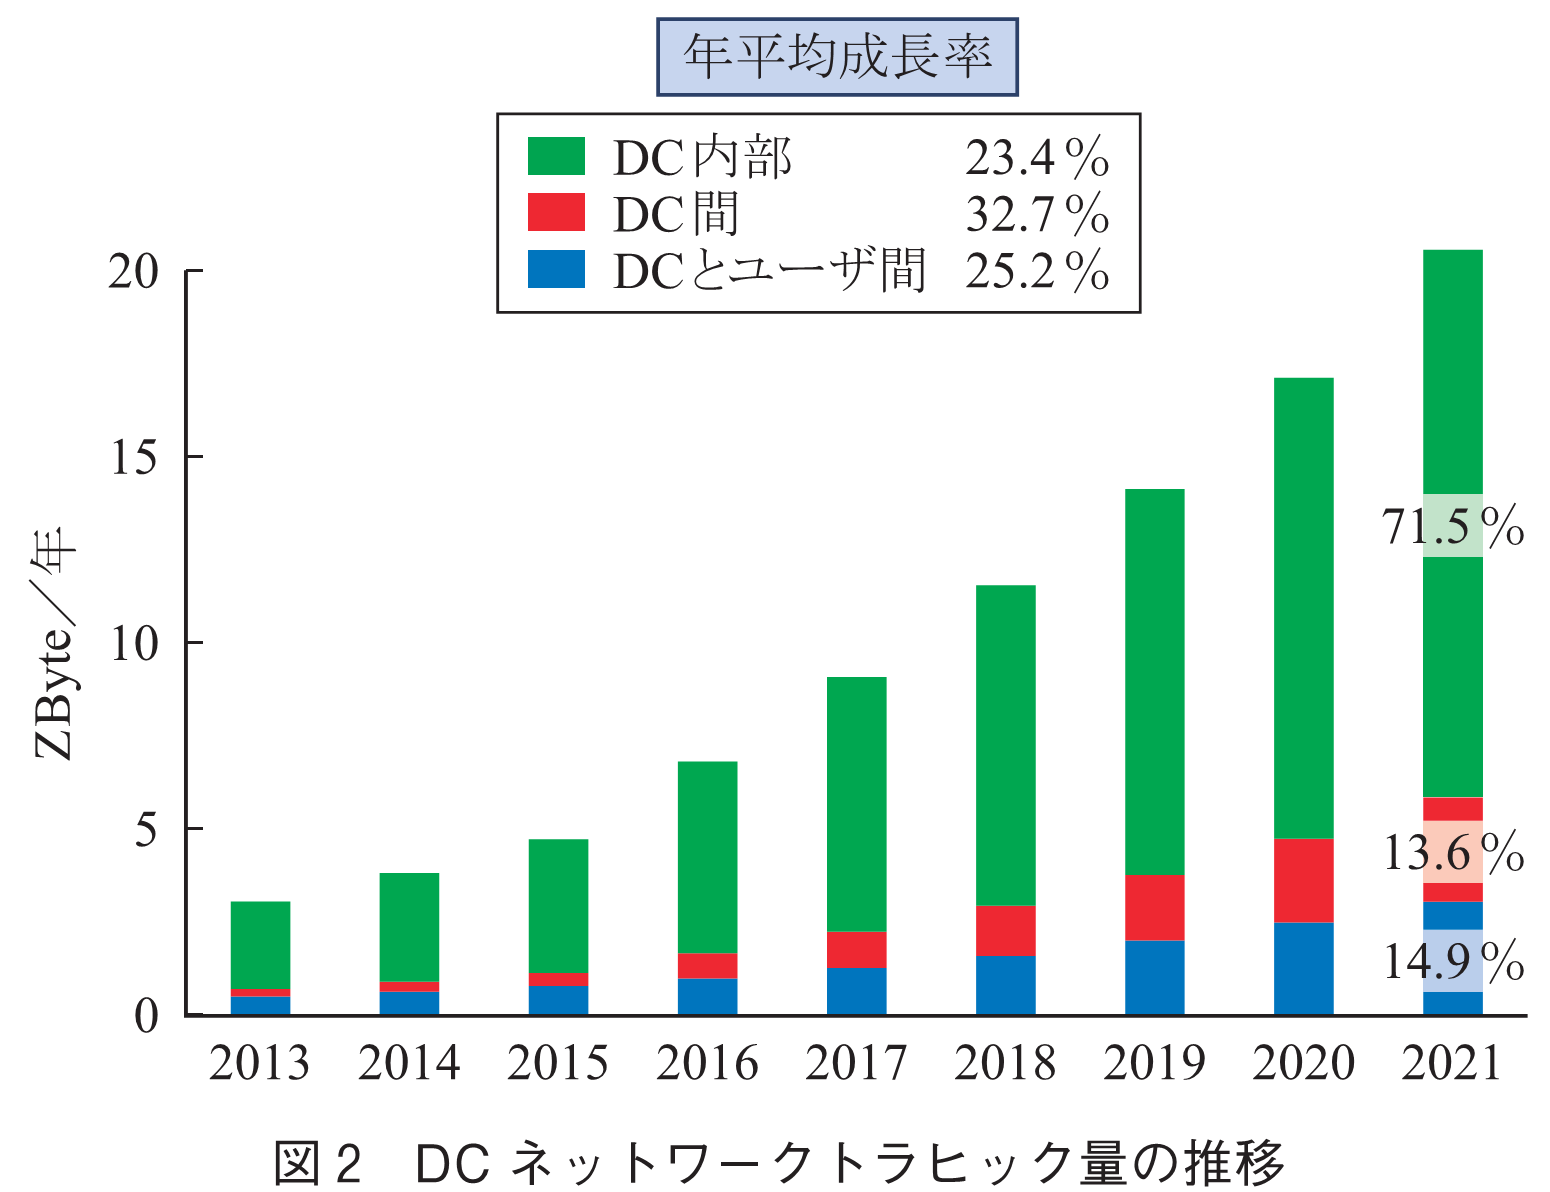
<p>　<a href="index.html#u_2e0000_2efig-2">図2</a>は世界のDCトラヒックの推移を示したものである<a href="#u_2e0000_2eref02"><sup>(2)</sup></a>．全体では年率25%で増加しているが，AIの導入が先行するDC（例えばGoogleのDC<a href="#u_2e0000_2eref03"><sup>(3)</sup></a>）では，年率70%以上で爆発的に増加している．更に，DCにおいて重要な点は，DCとユーザ間のトラヒック（南北トラヒック）の5倍の膨大なトラヒックがDC内部のサーバ間（東西トラヒック）で発生することである．また，クラウドの成長によりDC間トラヒックも急増している．</p>
<div id="u_2e0000_2efig-2"><div class="gext fig" id="fig_2"><p><img alt="図2　DCネットワークトラヒック量の推移" src="images/fig_2.png"/></p>
</div>
</div>
<p class="line-gap"> </p>
<div class="wrapper level4" id="h_2e0000_2e2_2e1_E3_80_80_E3_83_8D_E3_83_83_E3_83_88_E3_83_AF_E3_83_BC_E3_82_AF_E5_B8_AF_E5_9F_9F_E3_81_AE_E6_8B_A1_E5_A4_A7"><h2>2.1　ネットワーク帯域の拡大</h2>
<p>　DCネットワーク拡大の歴史は，このような成長を続けるサービス／トラヒックとの戦いであり，</p>
<p class="line-gap"> </p>
<p class="li-1em left1em"><span class="gext width2em">・</span>Scale-up：ネットワークのリンク容量の向上</p>
<p class="li-1em left1em"><span class="gext width2em">・</span>Scale-out：サーバ台数及びネットワークの拡張</p>
<p class="line-gap"> </p>
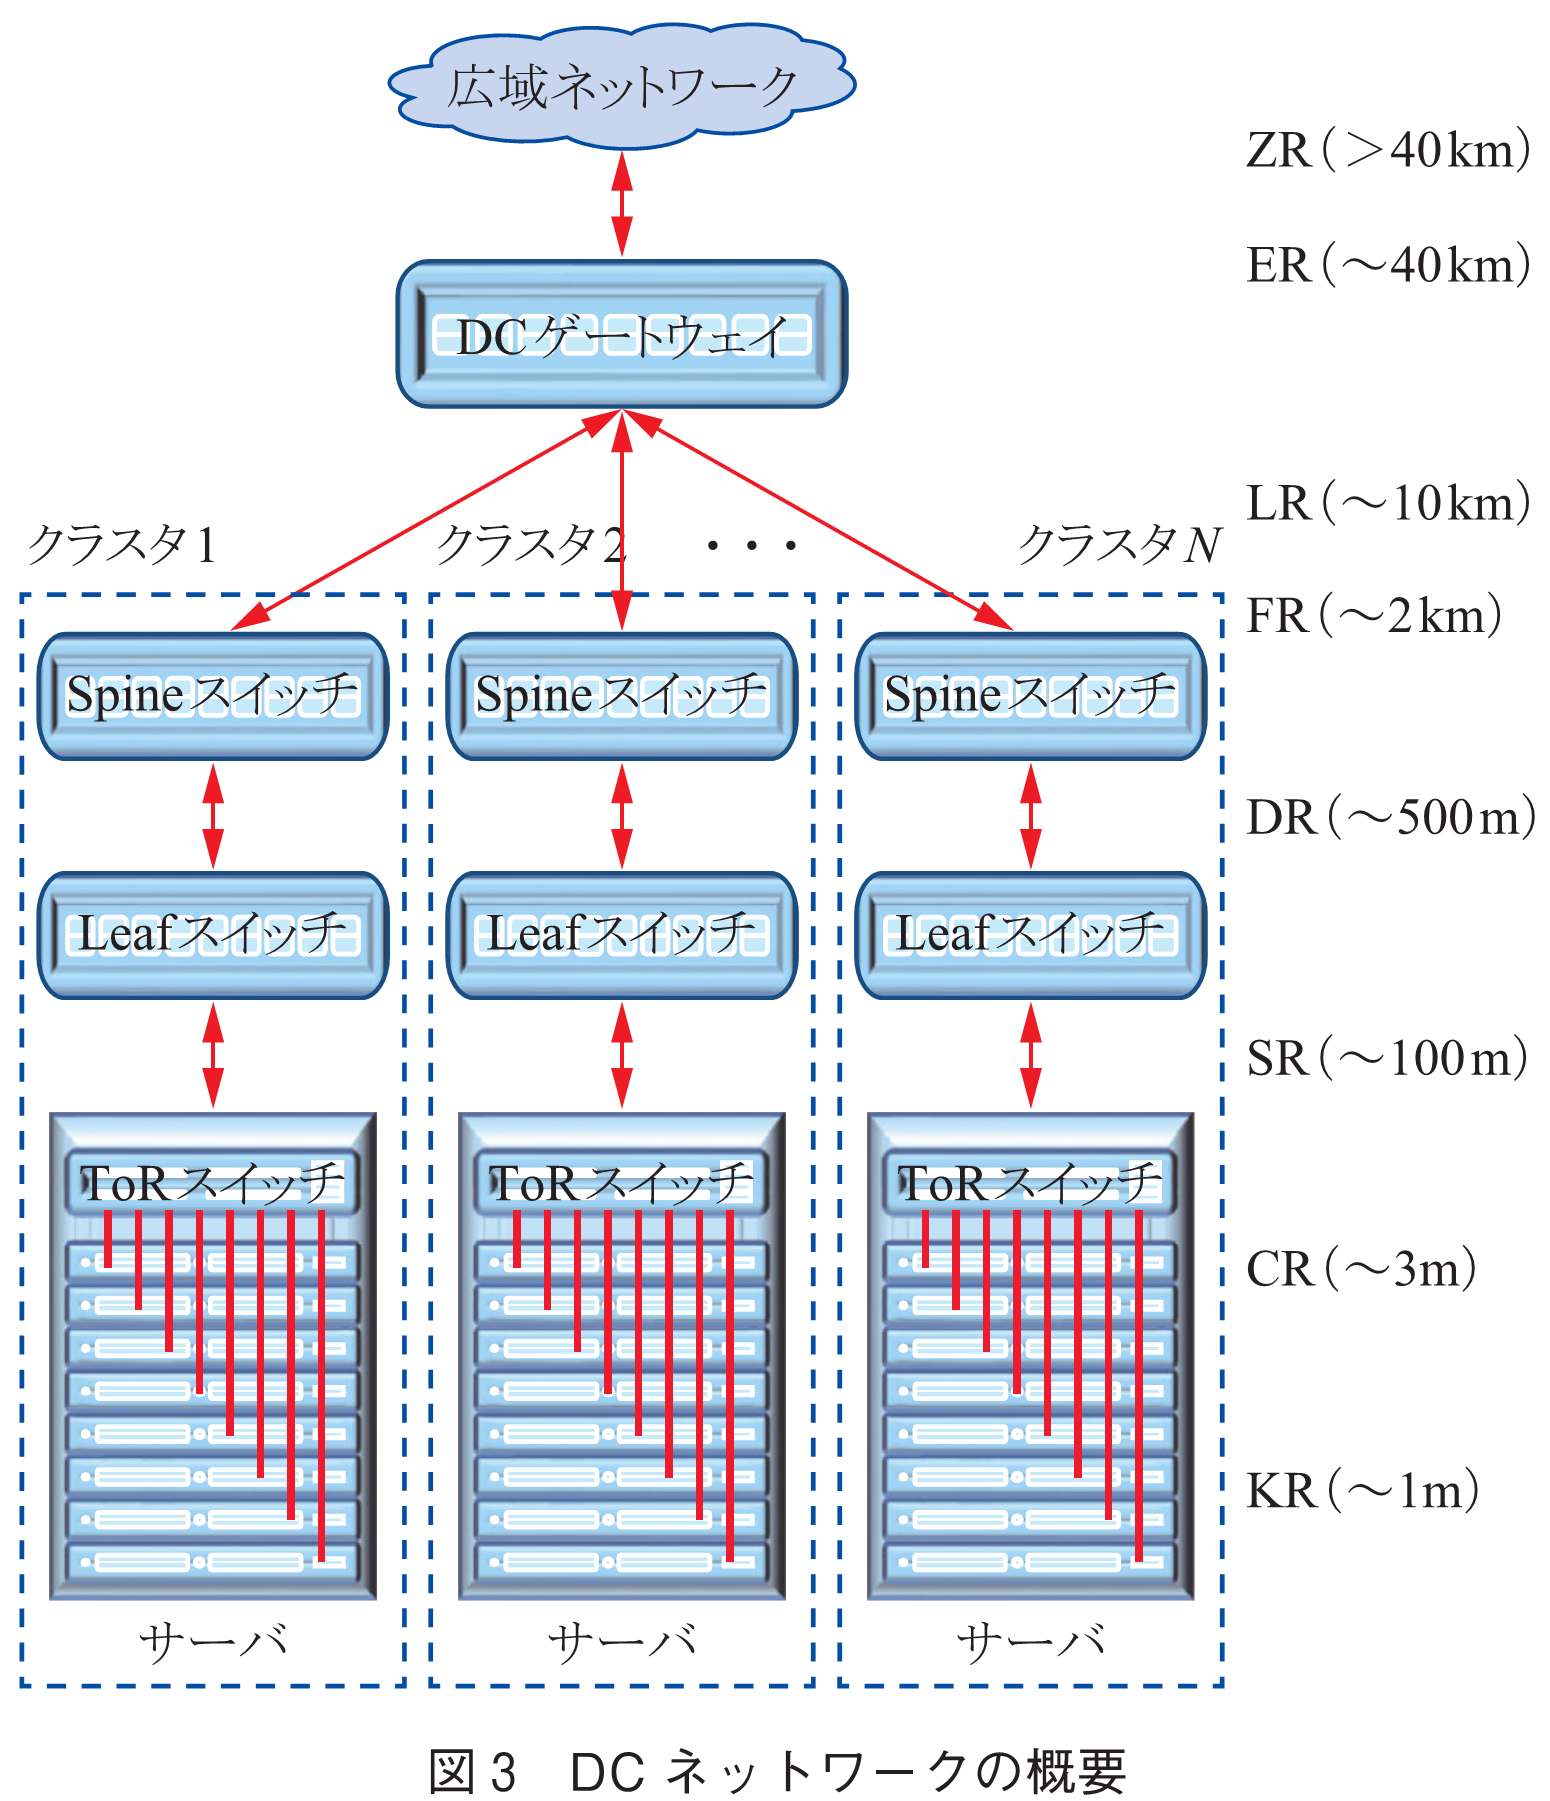
<p>に基づく様々な技術革新に支えられ成長してきた．その結果，近年ではサーバ100万台規模の巨大なDCが作られているが，<a href="index.html#u_2e0000_2efig-3">図3</a>に示すようにサーバ数万台～数十万台ごとのクラスタに分けられ，DCゲートウェイ/WAN（広域ネットワーク）を介して，他のDCやユーザと接続されている．図中右側は各装置間のおおよその距離とそれに対応したトランシーバの規格を表す．DCネットワーク（クラスタ内）で主に使用されるSR/DR光トランシーバは，近年800Gbit/sまで実現されており，更に1.6Tbit/sに向けて開発が進められている．</p>
<div id="u_2e0000_2efig-3"><div class="gext fig" id="fig_3"><p><img alt="図3　DCネットワークの概要" src="images/fig_3.png"/></p>
</div>
</div>
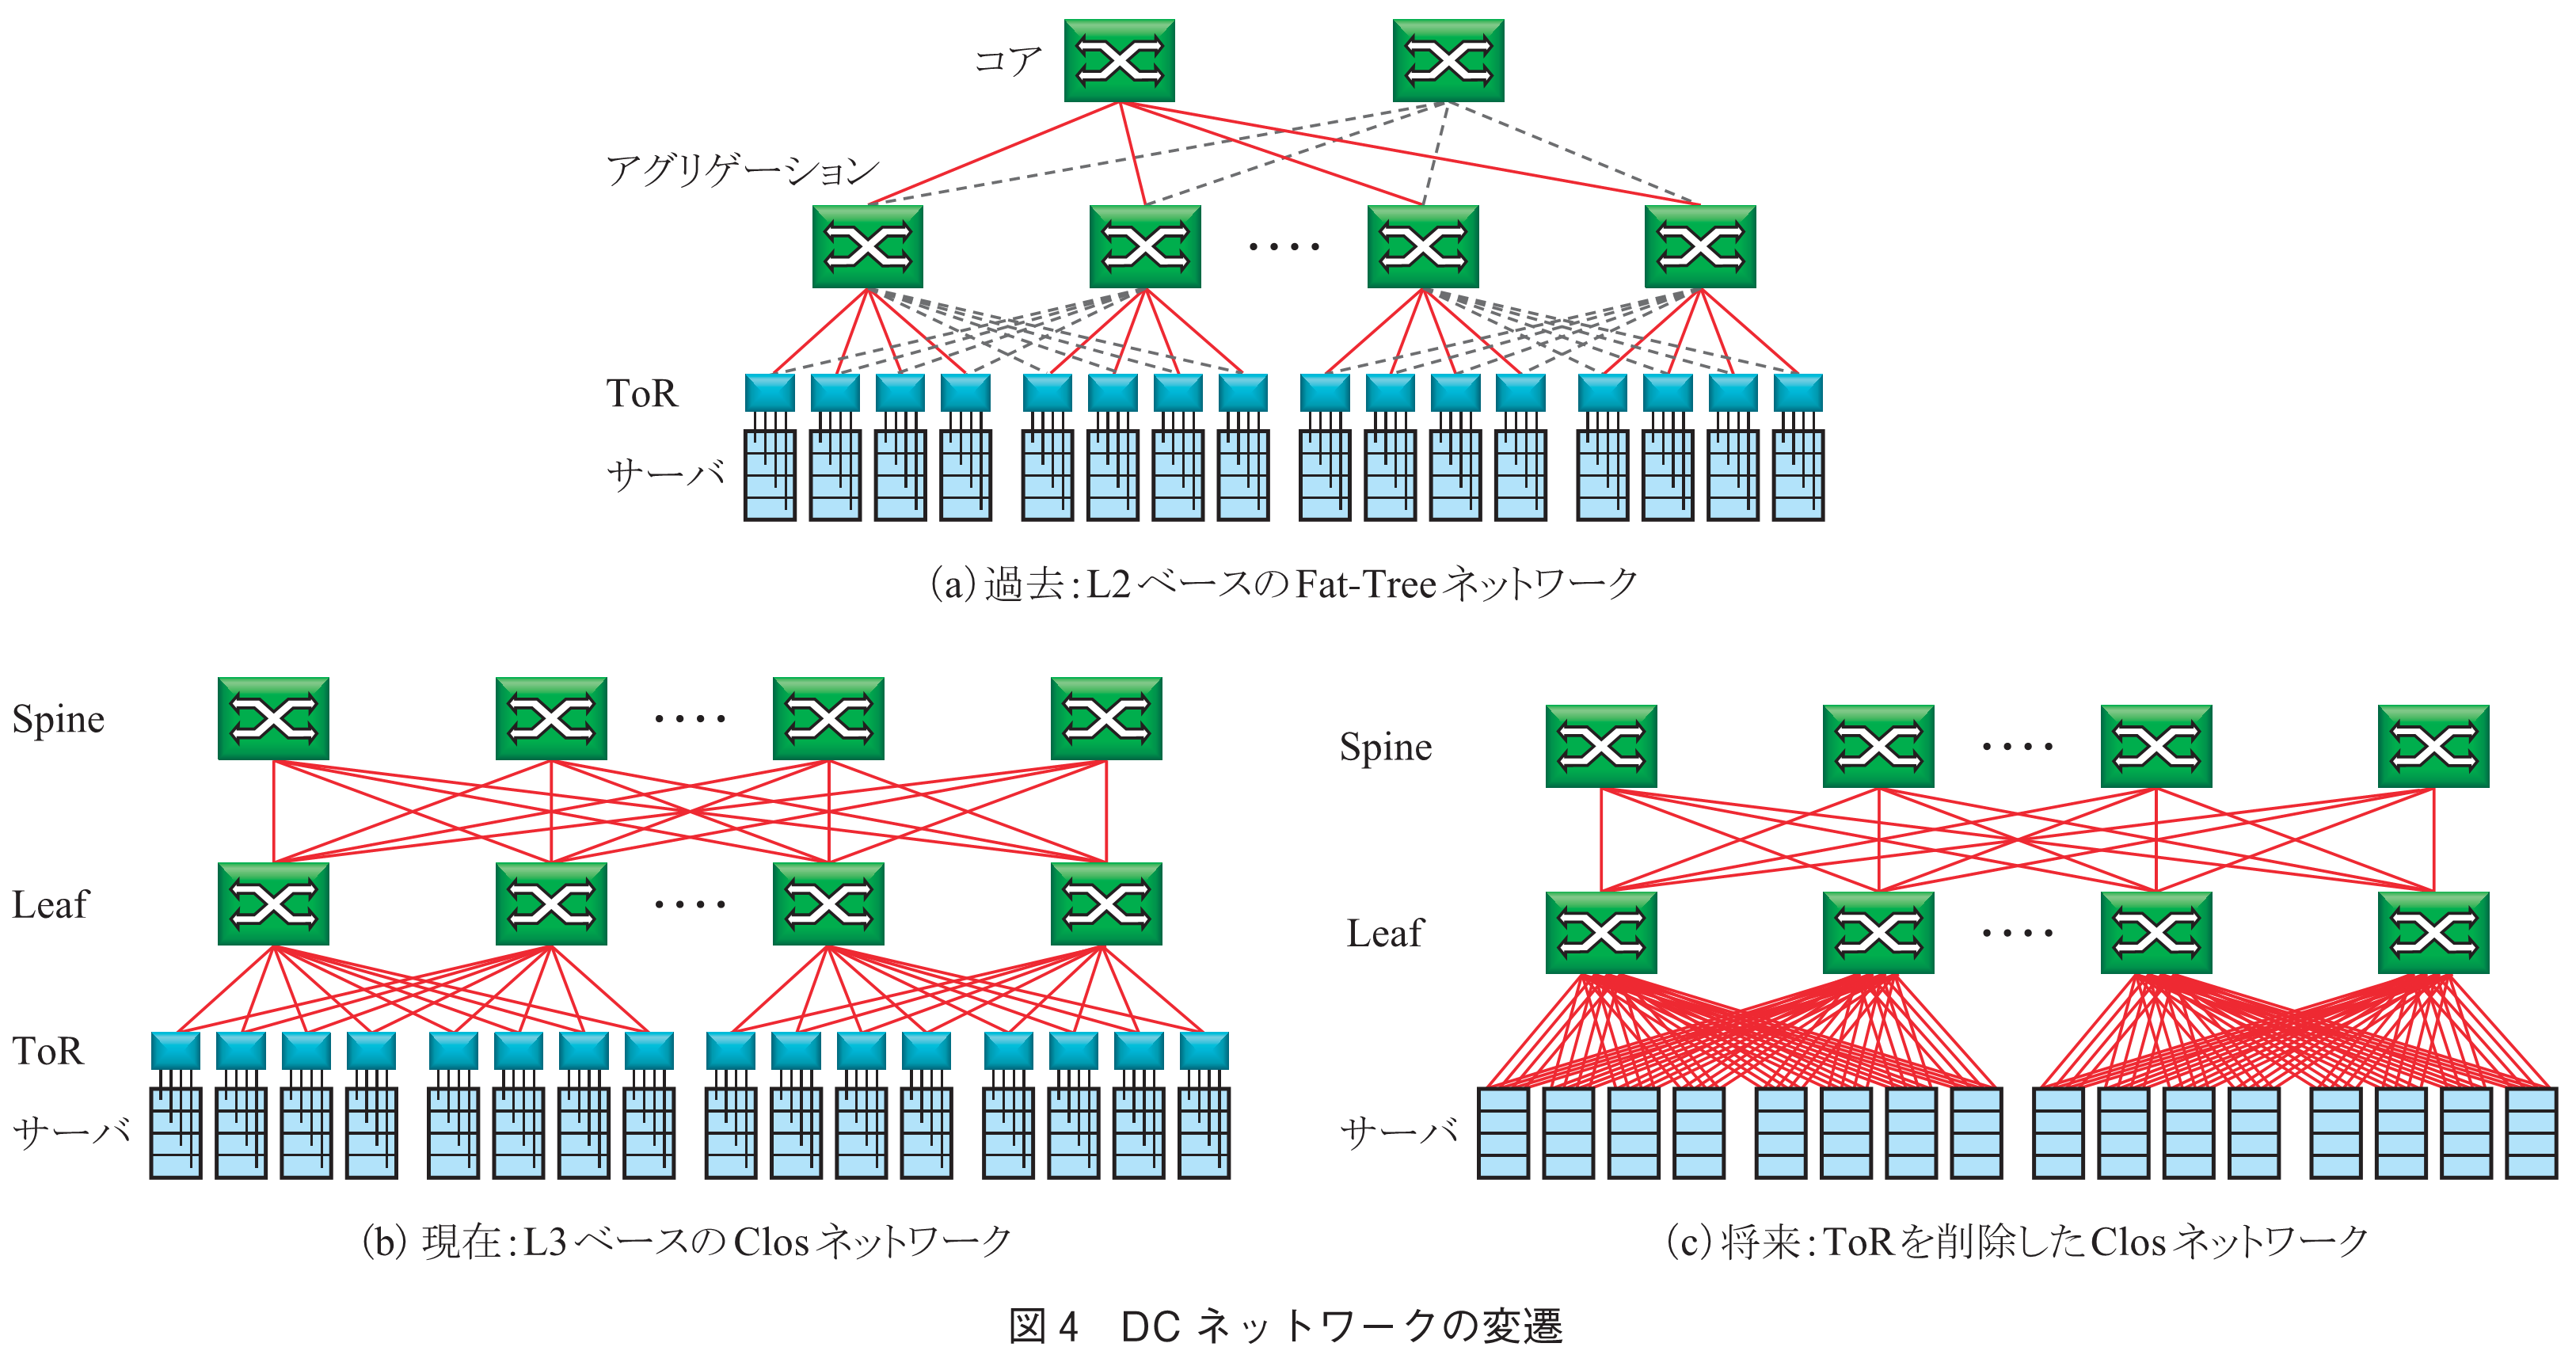
<p>　このクラスタ内のネットワーク構成を<a href="index.html#u_2e0000_2efig-4">図4</a>に示す．<a href="index.html#u_2e0000_2efig-4">図4</a>(a)は初期の構成で，ToRスイッチ（Top of Rack，ラックの上部に配置されたスイッチ），アグリゲーションスイッチ，コアスイッチの階層形Fat-Treeトポロジーが用いられていた．ここでは，レイヤ2の制御プロトコルであるSTP: Spanning Tree Protocolが用いられており，ネットワークのループにおいてデータが永続的に流れ続けるのを防止するため，点線のリンクがブロックされることとなる．更に，コアスイッチにデータが集中するため，極めて大容量のスイッチが必要となる．当初，南北トラヒックが主であった時代は本構成で対応してきたが，前述のとおり，サーバ仮想化による東西トラヒックの増大が進むにつれ，ネットワークの帯域不足に起因して拡張性に限界が見えてきた．そのため2000年代中頃から，<a href="index.html#u_2e0000_2efig-4">図4</a>(b)に示すClosネットワーク（3階層のスイッチ装置を相互接続したネットワーク構成の一種．Spineスイッチで折り返されているため，Folded Clos型とも呼ばれる）へ移行され<a href="#u_2e0000_2eref04"><sup>(4)</sup></a>，現在での主流となっている．ここでは，多数のToR，Leaf，Spineスイッチがお互いに複数の冗長リンクで連結されており，大幅に転送経路が拡張されている．更に，レイヤ3の経路制御プロトコル（主に，BGP: Border Gateway Protocol）が用いられるため，ループ回避の必要がなくなり，全てのリンクをアクティブに利用することが可能となる．そのため，爆発的に増大する東西トラヒックに対応して，ネットワーク帯域を大幅に拡張することが可能となった．</p>
<div id="u_2e0000_2efig-4"><div class="gext fig" id="fig_4"><p><img alt="図4　DCネットワークの変遷" src="images/fig_4.png"/></p>
</div>
</div>
<p class="line-gap"> </p>
</div>
<div class="wrapper level4" id="h_2e0000_2e2_2e2_E3_80_80_E6_B6_88_E8_B2_BB_E9_9B_BB_E5_8A_9B_E3_83_BB_E9_81_85_E5_BB_B6_E6_99_82_E9_96_93_E3_81_AE_E4_BD_8E_E6_B8_9B"><h2>2.2　消費電力・遅延時間の低減</h2>
<p>　DCの電力消費量が，2030年には全世界の電力消費量の8～10%程度に増加すると予測されており，低消費電力化が極めて重要な課題である．更に，高度な情報処理能力を必要とするAI/HPCサービスが増加するにつれて，ネットワークでのデータ転送遅延が大きな障害となっている．これら消費電力や遅延問題を解決するため，以下のような幾つかの方策が検討されている．</p>
<p class="line-gap"> </p>
<p class="lft li-1em left1em">◆次世代光トランシーバへの移行</p>
<p>　光リンクの高速化に伴い，従来のプラガブル光トランシーバでは，信号補償・誤り訂正機能が複雑となり，消費電力及び遅延が上昇する．この問題を解決するために，スイッチASIC（Application Specific Integrated Circuit，スイッチの機能に特化した大規模集積回路．後述の<a href="index.html#u_2e0000_2efig-6">図6</a>参照）近傍に配置した次世代光トランシーバの研究が活発に行われている（<strong class="m-gothic">3．</strong>参照）．</p>
<p class="line-gap"> </p>
<p class="lft li-1em left1em">◆Store &amp; Forward方式からCut-through方式への移行</p>
<p>　従来のStore &amp; Forward方式では，スイッチASICは入力パケット全体をメモリに取り込んだ後にヘッダの宛先を認識し転送処理を行うが，Cut-through方式では，ヘッダ部分を取り込んだ時点で認識・転送を行うために，スイッチでの転送遅延を大幅に短縮できる．これは，入出力のパケットが同一フォーマット（速度変換等がない）であることが必要であり，Spineスイッチでの導入が行われている<a href="#u_2e0000_2eref04"><sup>(4)</sup></a>．</p>
<p class="line-gap"> </p>
<p class="lft li-1em left1em">◆ネットワーク階層の削減，フラット化</p>
<p>　現在は，サーバからの信号は電気配線でToRに送られ，その後高速な光信号としてLeafスイッチに送られる．将来は<a href="index.html#u_2e0000_2efig-4">図4</a>(c)に示すように，サーバから直接高速光信号として出力させることでToRを削除して，ネットワークの階層を削減することが検討されている<a href="#u_2e0000_2eref05"><sup>(5)</sup></a>．</p>
<p class="line-gap"> </p>
<p class="lft li-1em left1em">◆単一スイッチASICを用いた超多ポートスイッチ</p>
<p>　1台のLeaf/Spineスイッチの内部では，多数のスイッチASICを用いてClos構成を組むことで多ポート化（例えば，128ポート）を実現している<a href="#u_2e0000_2eref06"><sup>(6)</sup></a>．そのため，サーバ間のデータ転送に対し，最多で9回もスイッチASICを通過することとなる．しかし，将来例えば51.2Tbit/sの大容量スイッチASICを用いて，一つのASICで400Gbit/s×128ポートのスイッチ装置が実現できれば，ASIC数の削減及びサーバ間転送を最多で5回に削減することができる．しかし，現在のプラガブル光トランシーバでこれを実現するのは困難であり，前述の次世代超小形光トランシーバの開発が必要である<a href="#u_2e0000_2eref05"><sup>(5)</sup></a>．</p>
<p class="line-gap"> </p>
<p class="lft li-1em left1em">◆光スイッチネットワークへの移行<a href="#u_2e0000_2eref07"><sup>(7)</sup></a></p>
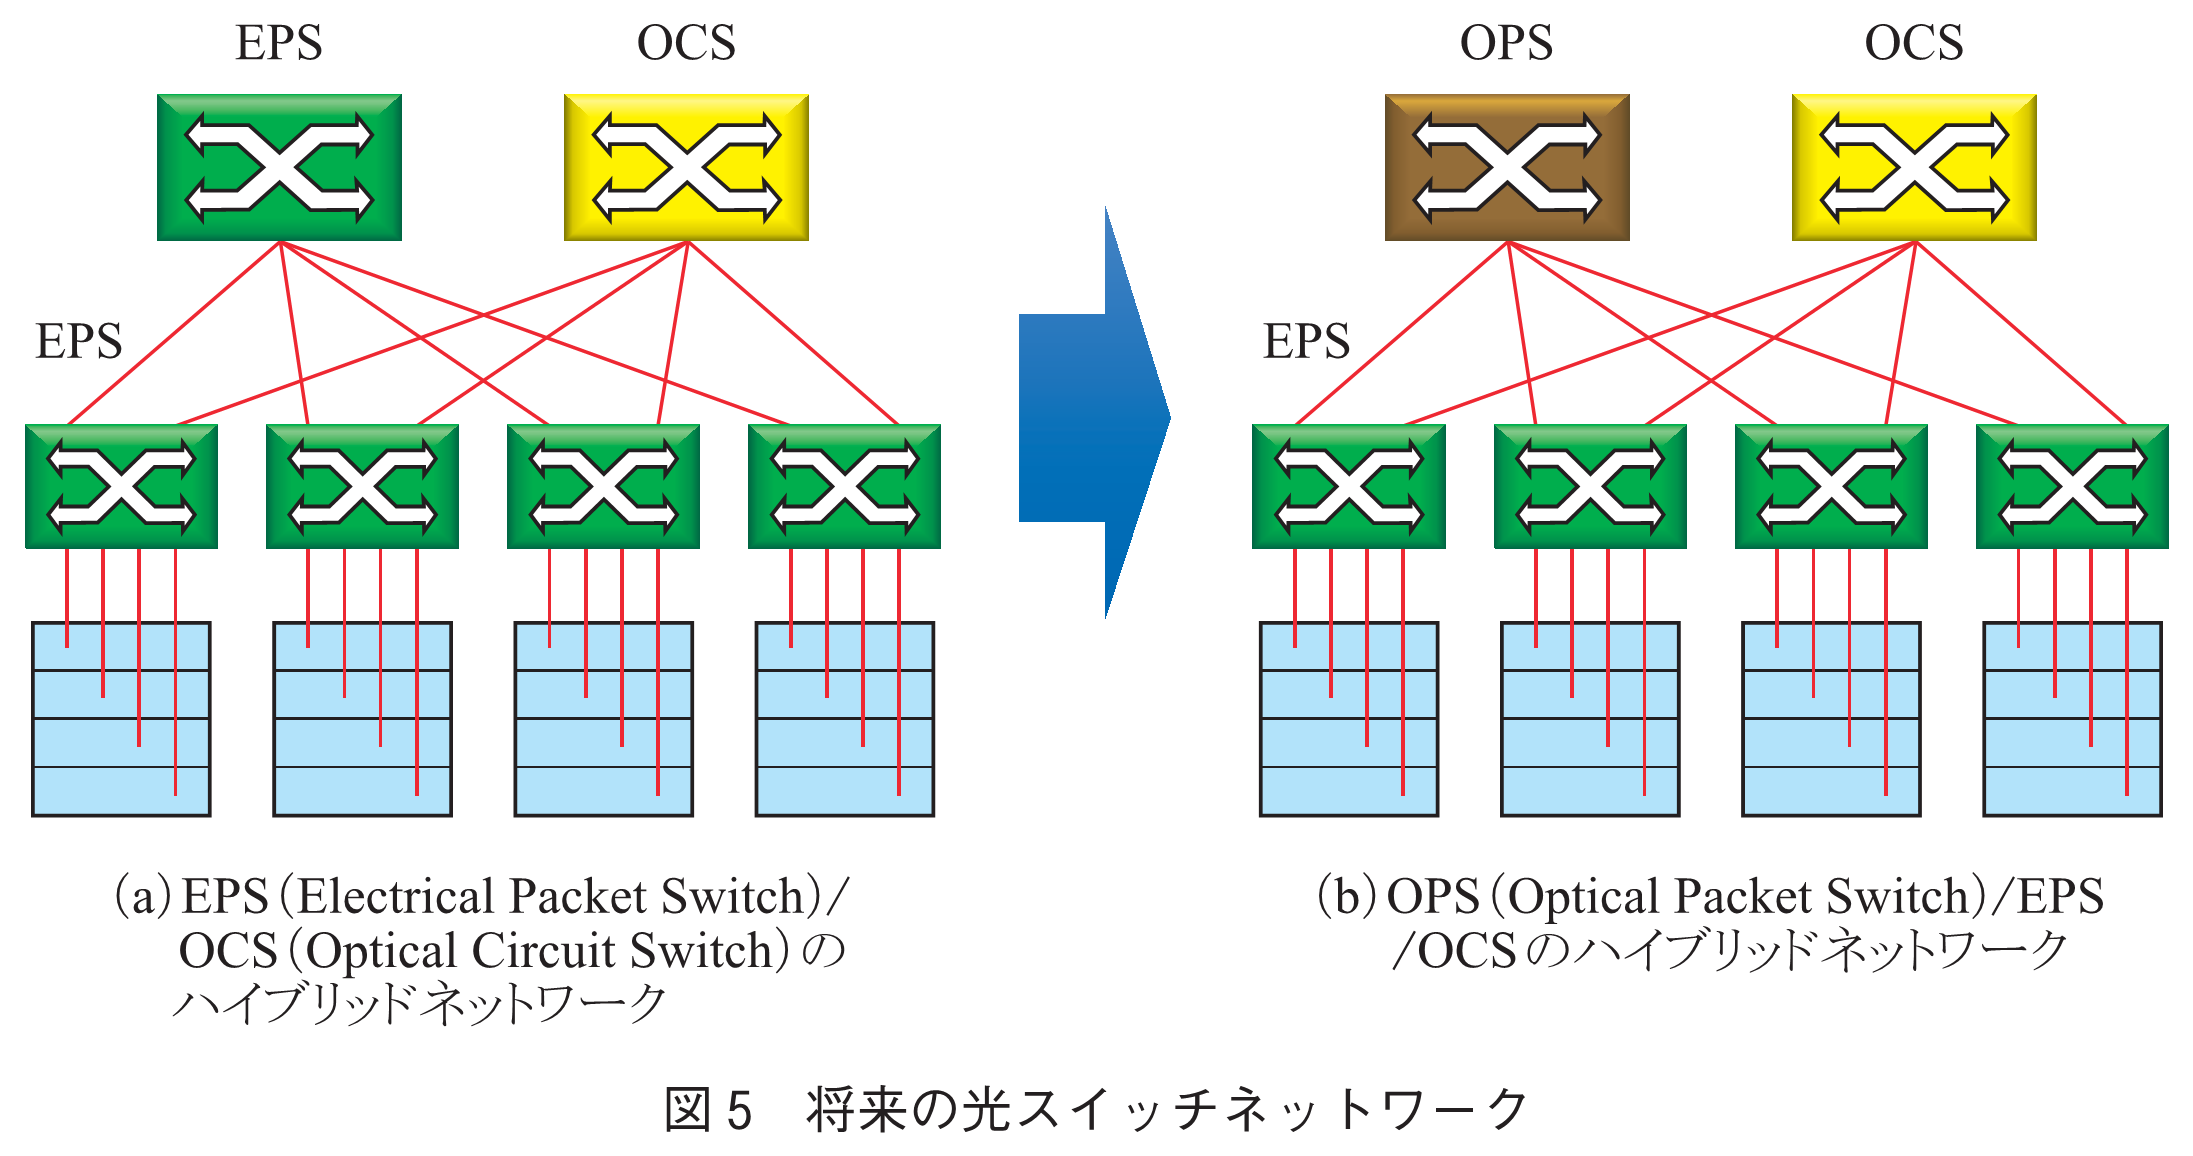
<p>　究極の低消費電力化・低遅延化の方法は，電気スイッチの代わりに光スイッチを用いた光スイッチネットワークの導入である．<a href="index.html#u_2e0000_2efig-5">図5</a>(a)は第1ステップとして，OCS: Optical Circuit Switchと従来のEPS: Electrical Packet Switchのハイブリッドネットワークの概念を示す．OCSは，回線交換方式であり，スイッチ速度はミリ秒オーダと極めて遅く，衝突回避機能を持たない．そのため，パケット単位でのスイッチングではなく，バックアップデータ等の極めて大きなデータのオフロードに用いられる．更に将来には<a href="index.html#u_2e0000_2efig-5">図5</a>(b)に示すように，OPS: Optical Packet Switchの導入が期待される．OPSはEPSと同様にヘッダ認識，スイッチ，バッファの基本三要素を有しており，衝突回避及びパケット単位での高速スイッチングが可能である．しかし，光の状態でこれら機能を実現するのは極めて困難である．特にその中核を担う光スイッチは，高速・低損失・偏波無依存等の要求を満たす必要があり，技術的障壁は極めて高い．そのため，OPSでは比較的ポート数の少ない光スイッチ（16×16程度）に適した新たなトポロジー（トーラス，DCell等）を用いたネットワークが提案されている．光スイッチシステムの詳細は，本小特集4「データセンターにおける光スイッチネットワーク技術の動向」を御覧頂きたい．</p>
<div id="u_2e0000_2efig-5"><div class="gext fig" id="fig_5"><p><img alt="図5　将来の光スイッチネットワーク" src="images/fig_5.png"/></p>
</div>
</div>
<p class="line-gap"> </p>
</div>
</div>
<div class="wrapper level3" id="h_2e0000_2e3_EF_BC_8E_E5_85_89_E3_82_A4_E3_83_B3_E3_82_BF_E3_82_B3_E3_83_8D_E3_82_AF_E3_82_B7_E3_83_A7_E3_83_B3"><h1>3．光インタコネクション</h1>
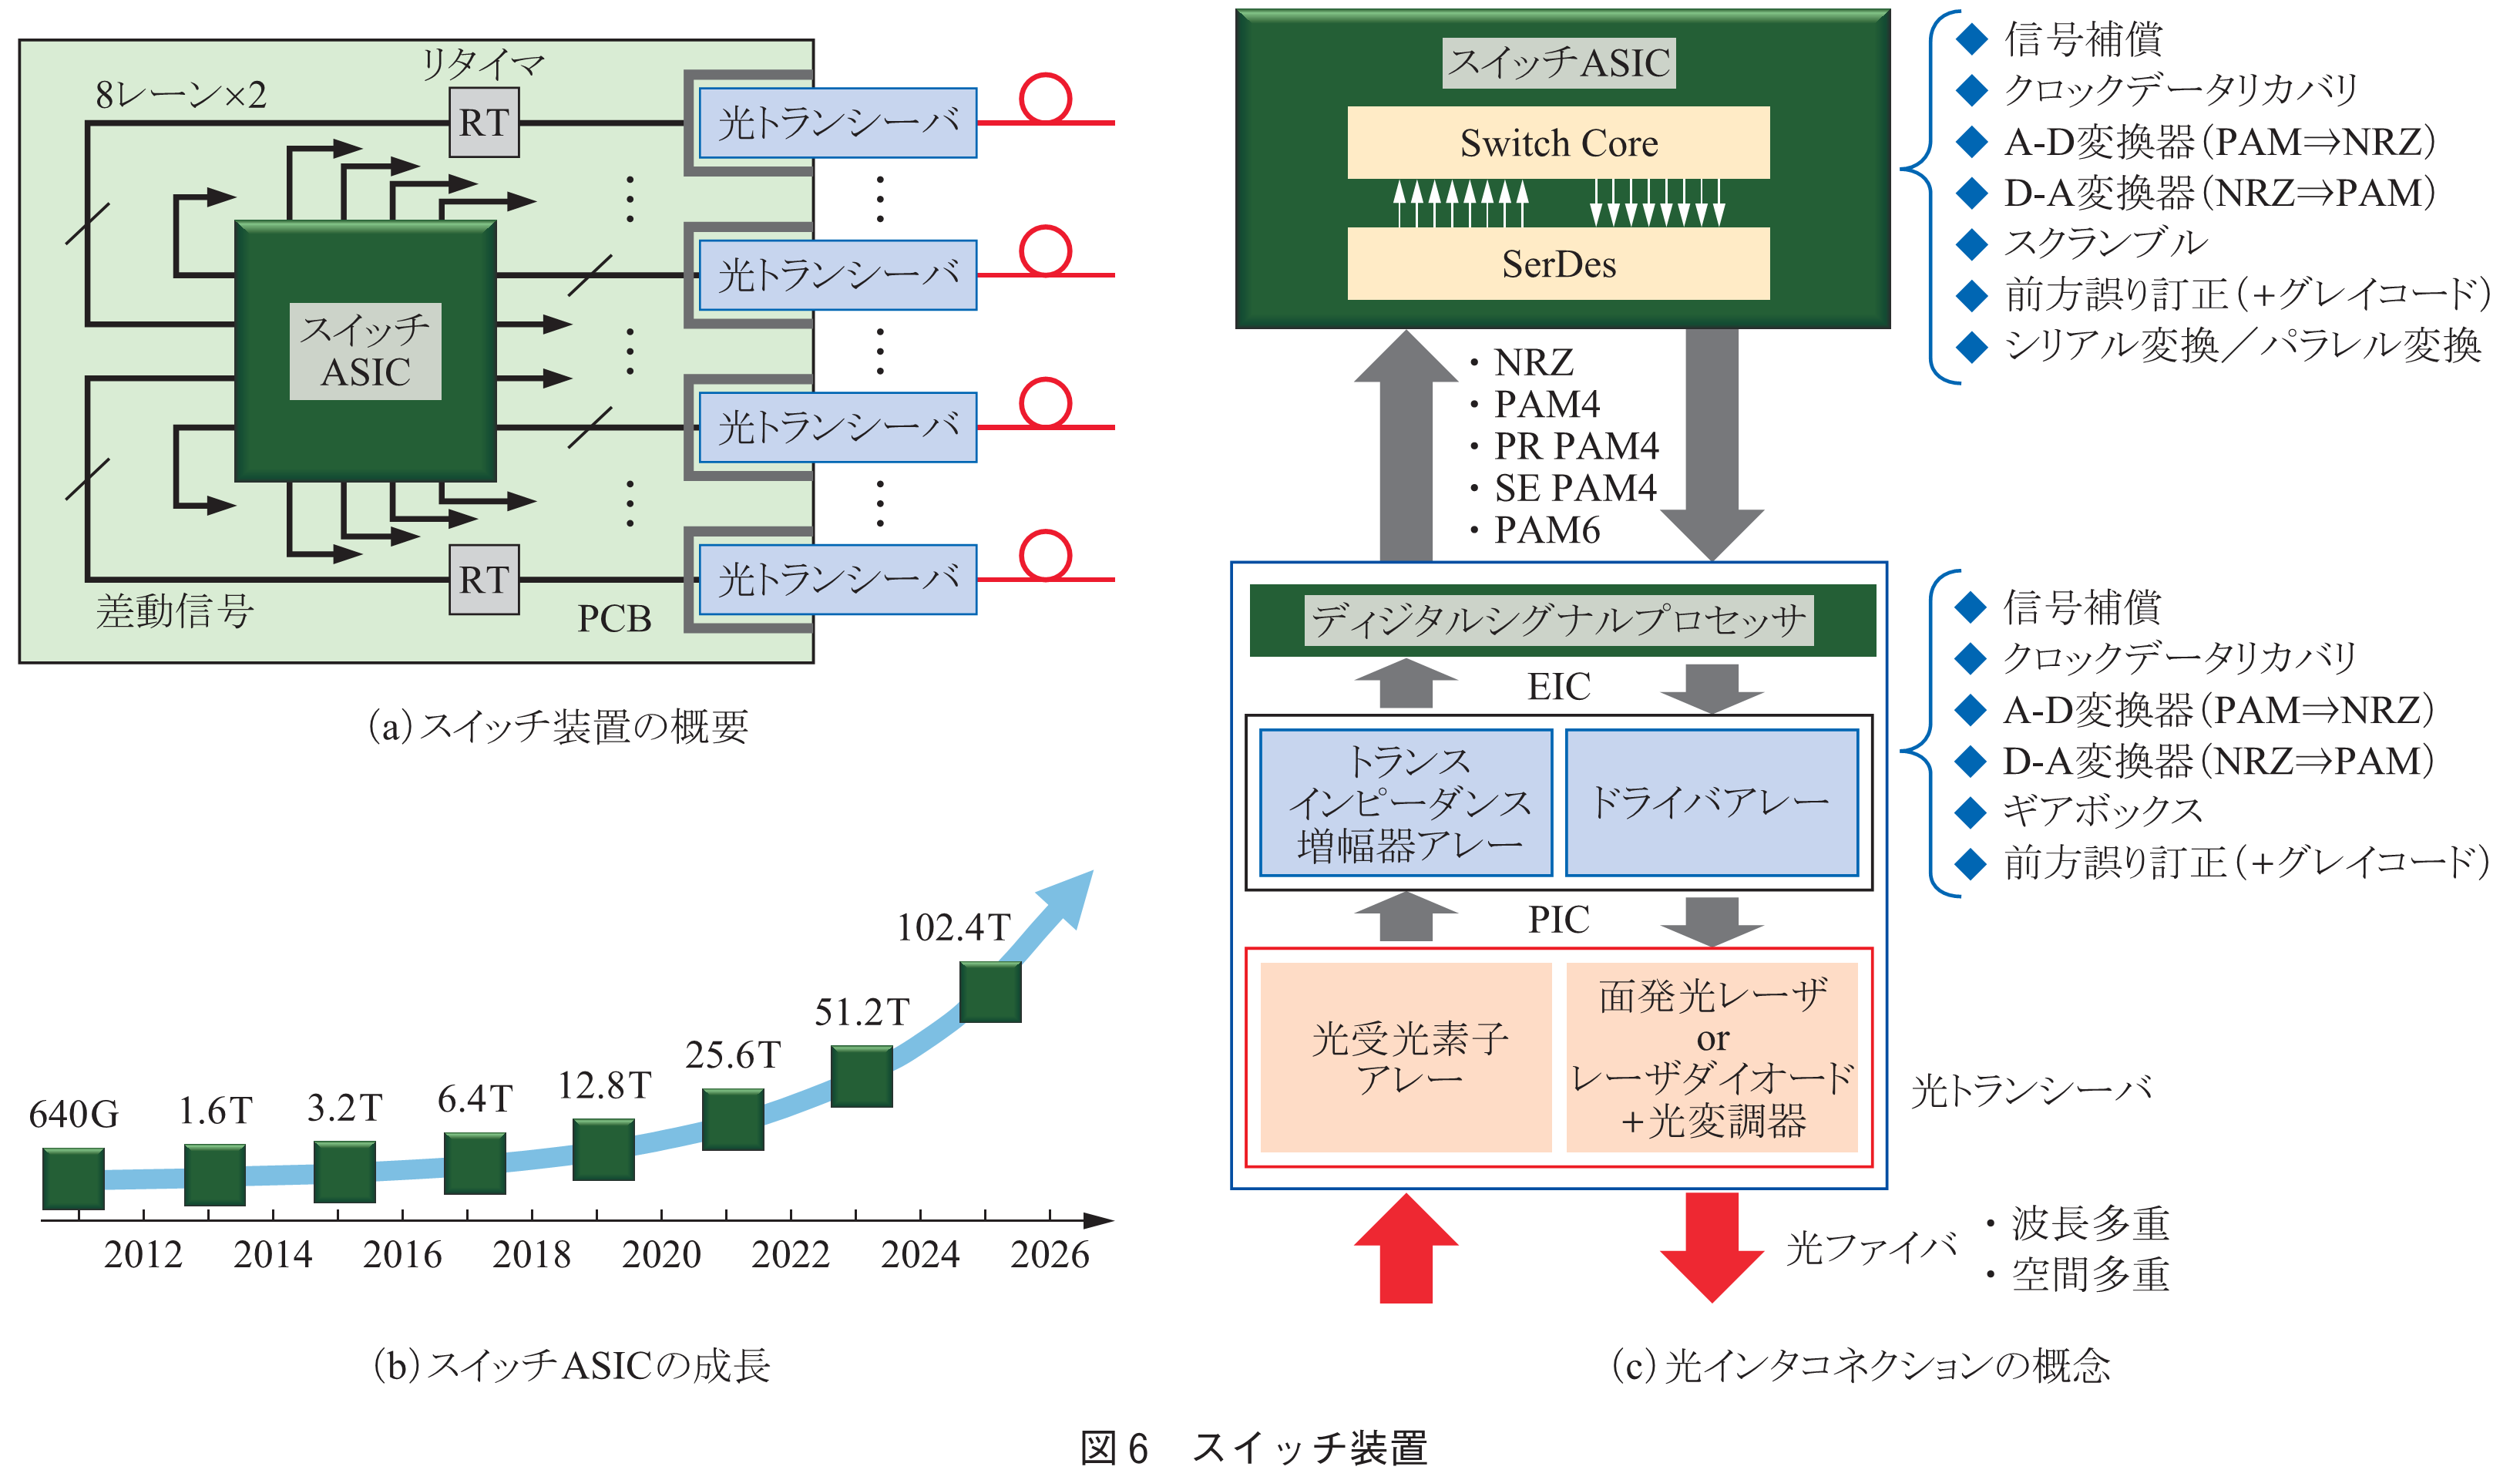
<p>　現在のスイッチ装置は，基本的にPCB（Printed Circuit Board）上にスイッチASICが置かれ，フロントパネルに装着される光トランシーバとそれぞれ数十cmの電気配線で接続される（<a href="index.html#u_2e0000_2efig-6">図6</a>(a)）．また，これが複数台接続されることで，一つのLeaf/Spineスイッチ装置が構成される．スイッチASICは2年ごとに2倍に成長しており（<a href="index.html#u_2e0000_2efig-6">図6</a>(b)），現状では25Tbit/sの大容量ASICが開発されている．しかし，このスイッチASICの成長に伴い，スイッチ装置では以下に示す様々な問題に直面している．</p>
<div id="u_2e0000_2efig-6"><div class="gext fig" id="fig_6"><p><img alt="図6　スイッチ装置" src="images/fig_6.png"/></p>
</div>
</div>
<p class="lft li-1em left1em">◆実装可能な光トランシーバ数の制限</p>
<p>　光トランシーバのフォームファクタ（形状の規格）は，CFPからQSFPへと小形化が進められたが，その後の小形化は困難な状況にある．そのため，フロントパネルに装着可能な光トランシーバ数は1U当り32個程度が限界である．</p>
<p class="line-gap"> </p>
<p class="lft li-1em left1em">◆高速・高密度電気配線の問題</p>
<p>　PCBとスイッチASICを接続する入出力ピン数には制限があるため<a href="#u_2e0000_2eref08"><sup>(8)</sup></a>，32個の各光トランシーバとスイッチASIC間は，入力・出力各8レーンの差動信号（計32本の電気配線）で接続される．現在400Gbit/sの光トランシーバでは50Gbit/sのPAM4（Pulse Amplitude Modulation）信号が用いられているが，電気信号の高速化に伴い，高周波成分の誘電損やクロストークなどに起因した伝送特性（信号波形）の劣化が大きな問題となる．近年，Flyover cable（細線同軸ケーブル）やMegtron系低損失基板が開発されたことで，800Gbit/s光トランシーバが実現可能となったが，1.6Tbit/sへの高速化にはいまだ多くの課題が残っている．</p>
<p class="line-gap"> </p>
<p class="lft li-1em left1em">◆信号処理・信号補償の問題</p>
<p>　スイッチASICと光トランシーバ間では，信号波形が大きく劣化するため，<a href="index.html#u_2e0000_2efig-6">図6</a>(c)に示す様々な信号処理・信号補償の機能が必要となる．スイッチASICの入出力部には高速信号を内部クロックの並列低速信号に変換するSerDes（Serializer/Deserializer）が集積されており，SerDes本来の機能以外にも信号補償（Equalization）や波形整形（CDR: Clock and Data Recovery），誤り訂正（FEC: Forward Error Correction）等の回路も含まれる．更に4値のPAM4信号の処理には，A-D変換器（ADC, Analog-to-Digital Converter）/D-A変換器（DCA, Digital-to-Analog Converter）が必要となる．光トランシーバ側には，DSP（Digital Signal Processor）チップが搭載され，同様に様々な機能が包含される．現在レーン当り200Gbit/sの高速化が議論されているが<a href="#u_2e0000_2eref09"><sup>(9)</sup></a>，そこでは従来不要であったDSP内でのFEC機能や新たな変調方式（PR-PAM4, PAM6/8等）が検討されている．このように従来のプラガブル光トランシーバは，電気信号の高速化に伴い，SerDes/DSP機能が複雑になり，消費電力・遅延が大きく増加するため，限界が見えてきた．</p>
<p class="line-gap"> </p>
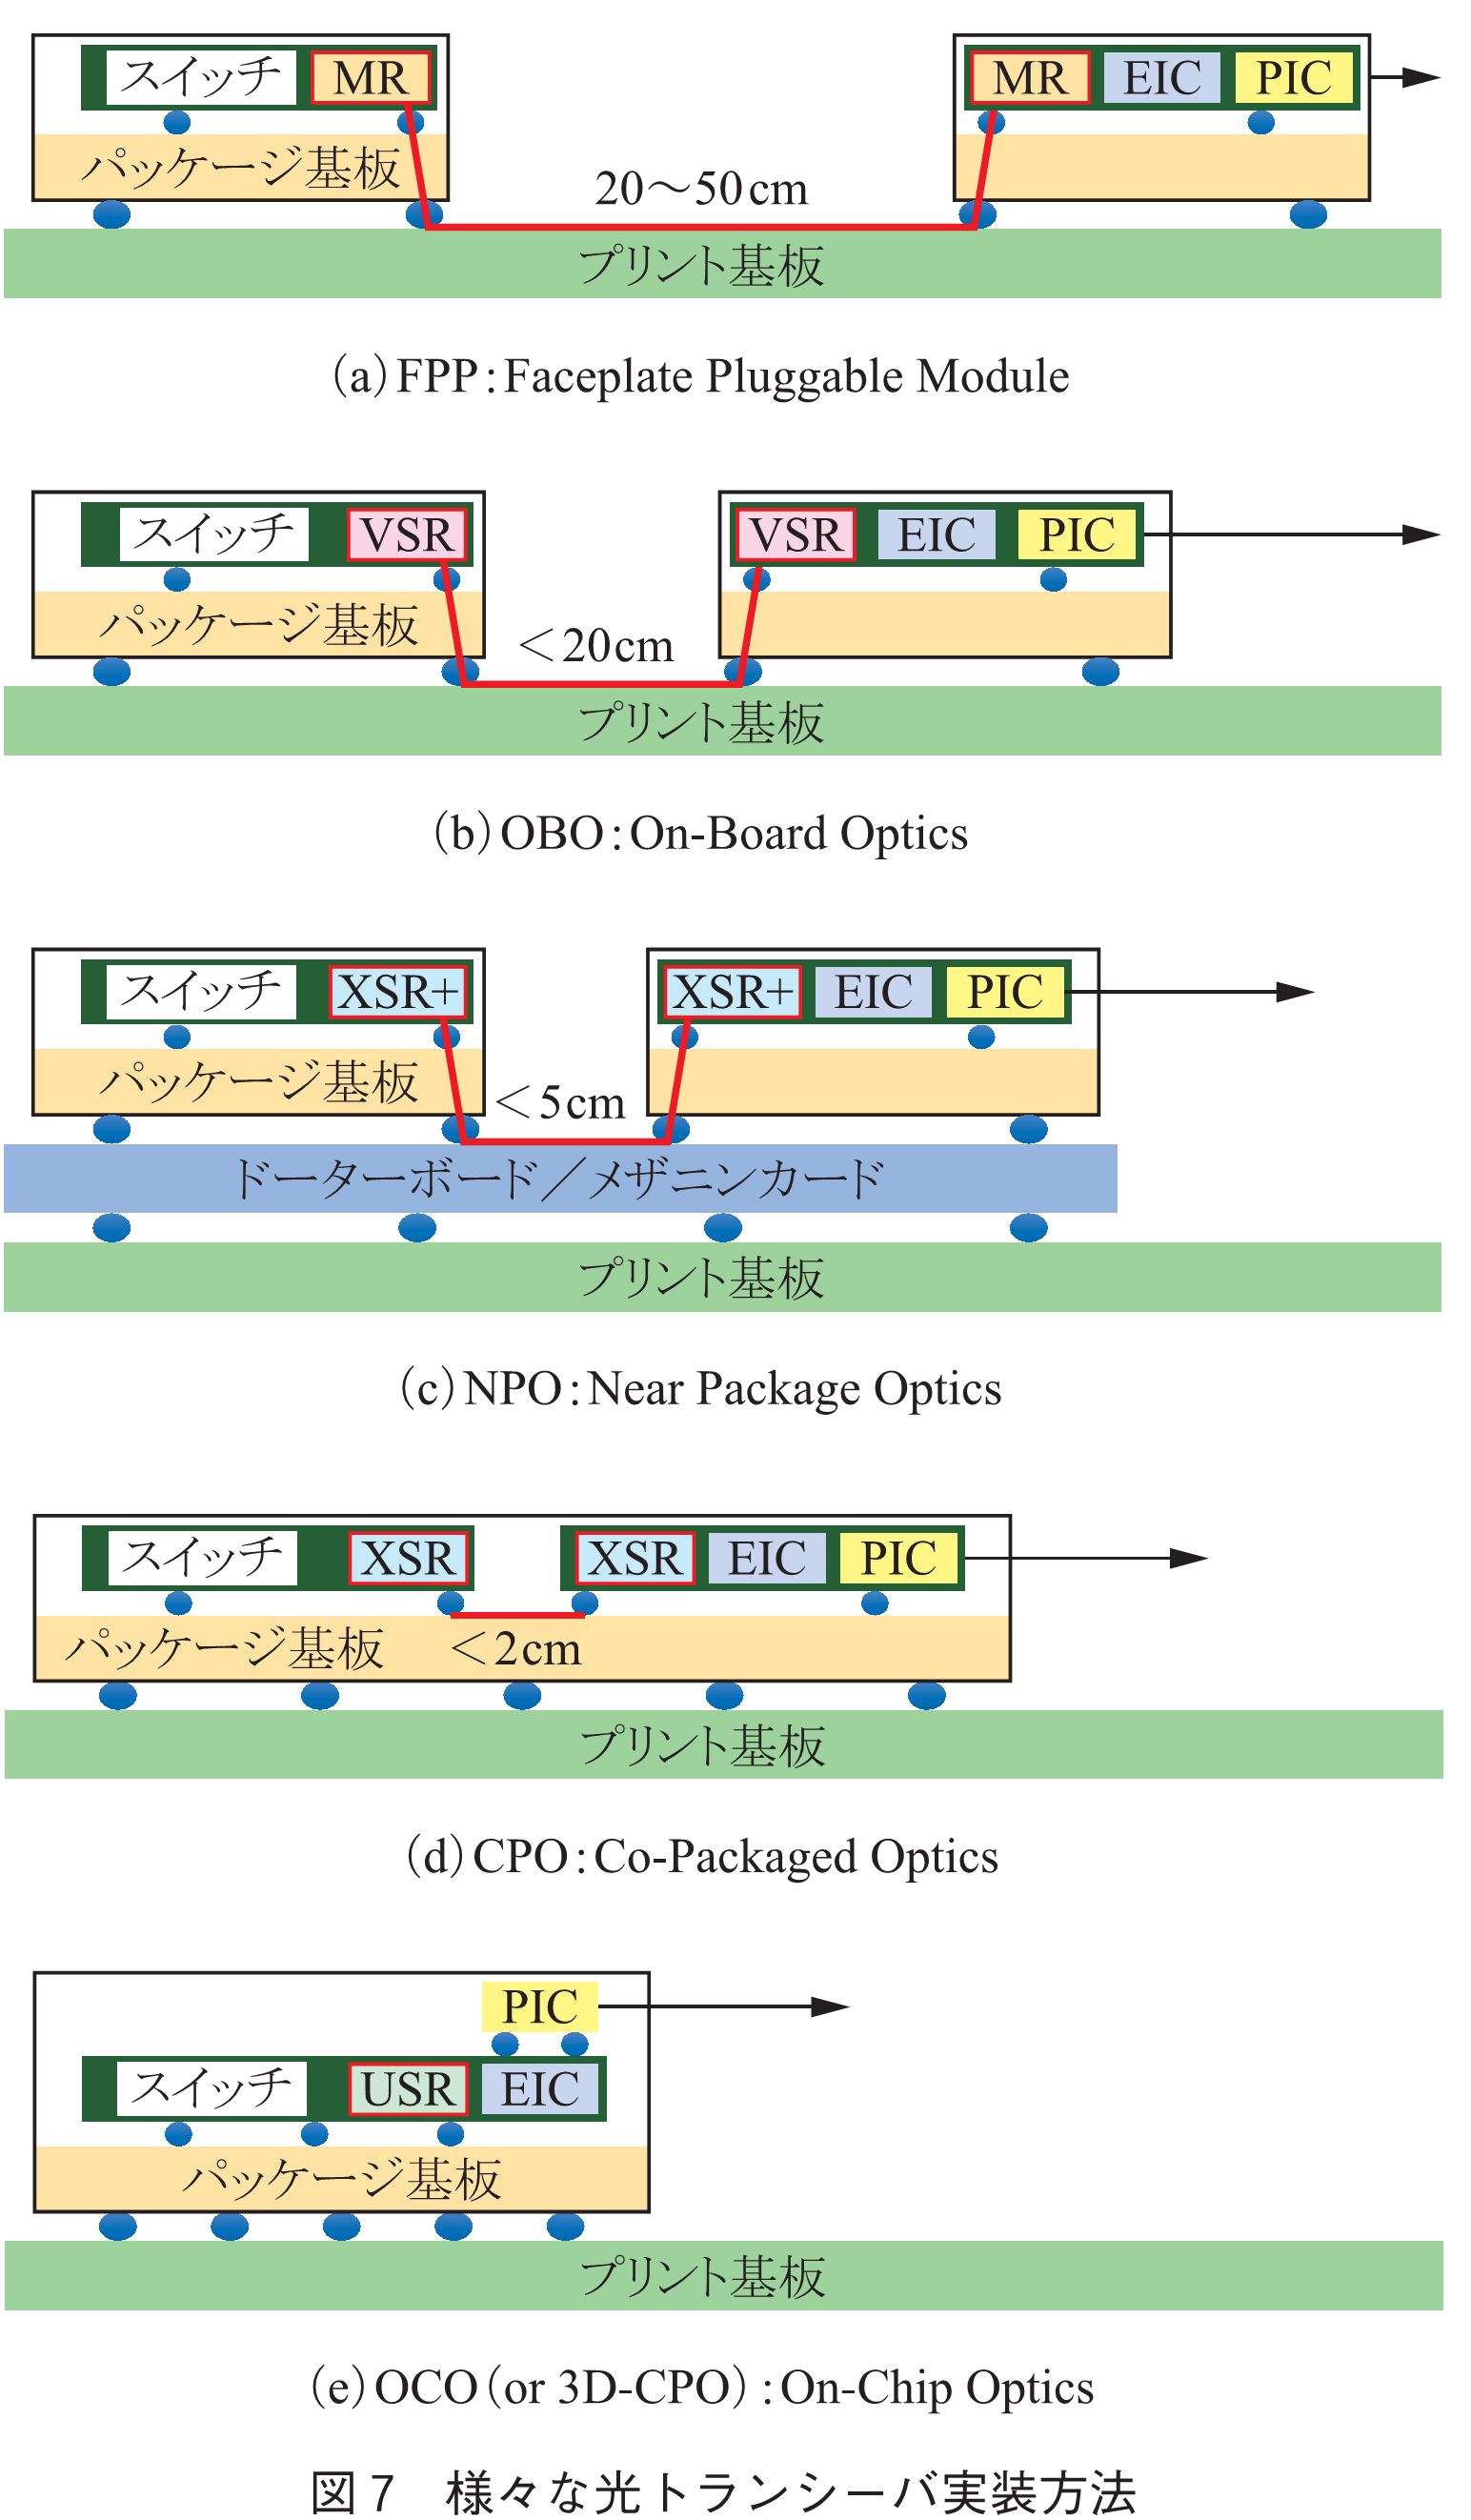
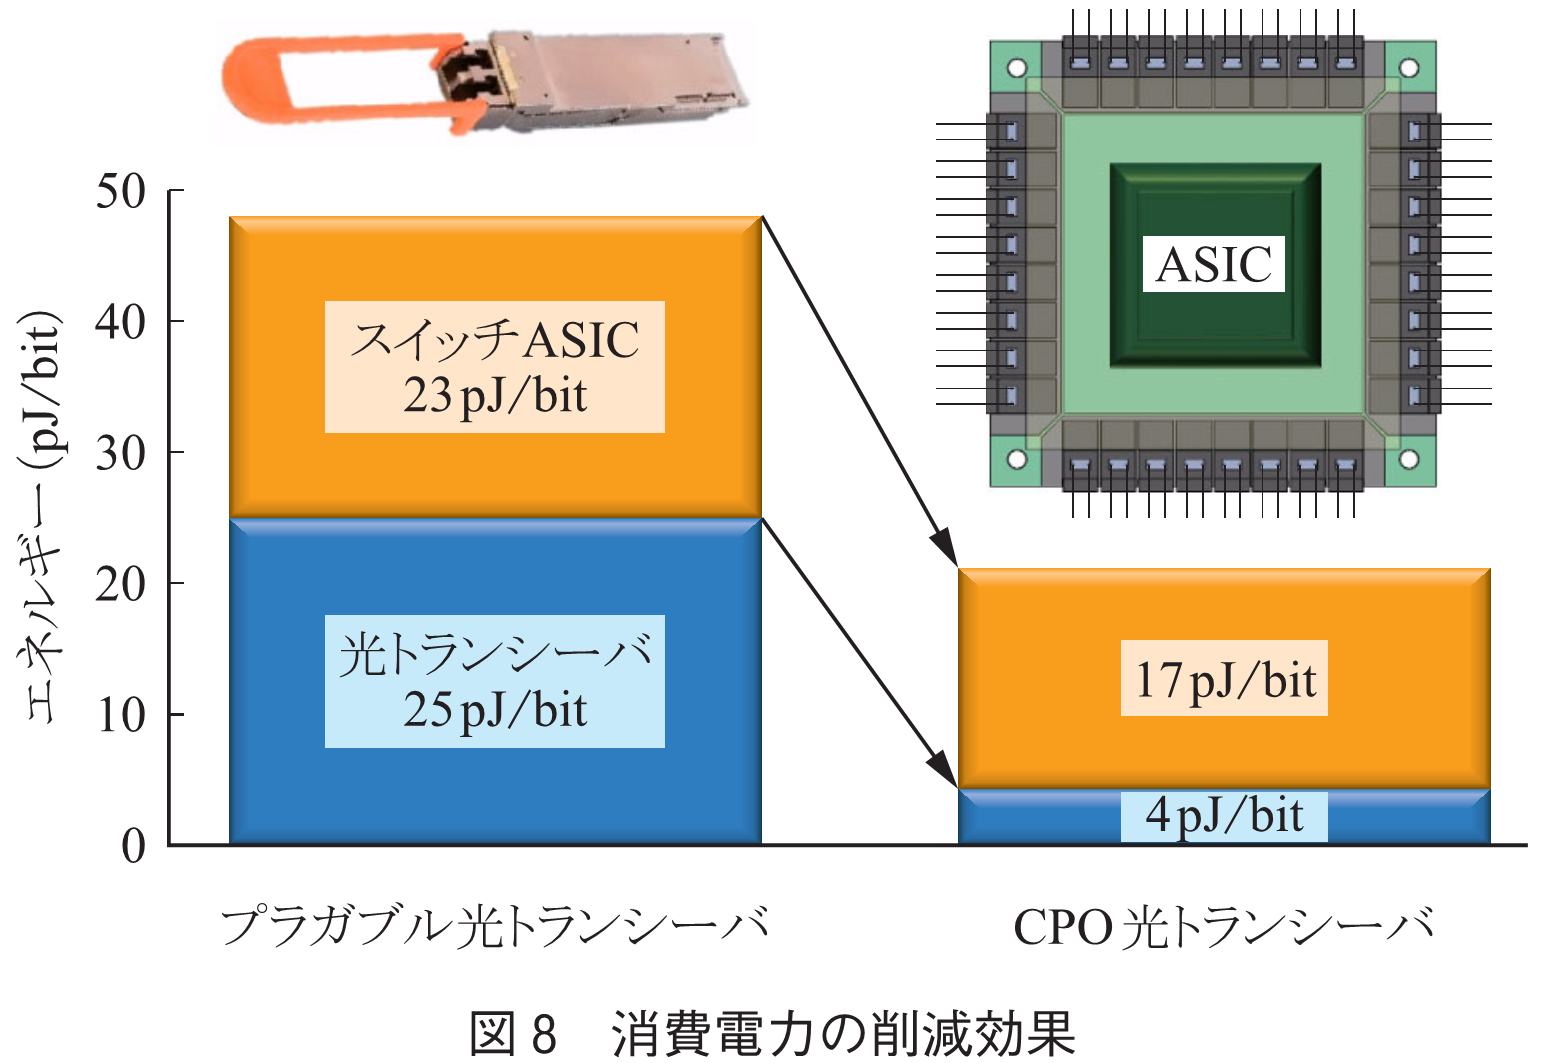
<p>　この問題を解決するためには，ASICと光トランシーバの距離を極力近づけ，その間での電気信号劣化を抑えることが重要である．そのため<a href="index.html#u_2e0000_2efig-7">図7</a>に示す様々な実装方法が提案され<a href="#u_2e0000_2eref05"><sup>(5)</sup></a><sup>,</sup><a href="#u_2e0000_2eref10"><sup>(10)</sup></a><sup>,</sup><a href="#u_2e0000_2eref11"><sup>(11)</sup></a>，近年特にNPO/CPOの次世代超小形光トランシーバは世界中で熾烈な開発競争が行われている．図中のXSRやVSR等の記号は，距離（伝送損）に応じたCEI（Common Electrical I/O）規格<a href="#u_2e0000_2eref12"><sup>(12)</sup></a>の名称であり，SerDesやDSPに必要な機能が定義されている．NPO/CPOでは，PCB上の電気配線を用いないため，入出力配線の並列数を増やし，NRZ信号の適用も可能となる．そのためDSP側の信号補償は非常に軽くなり，更にそれ以外の機能は全て削除できるため，大幅な低消費電力化が可能となる．また，信号補償回路等はドライバ等のEIC（Electrical Integrated Circuit）側に集積することで，DSPチップは不要となり，大幅な小形化が可能となる．同様にSerDes側の機能も低減されるため，スイッチASICの消費電力も削減される．その結果，<a href="index.html#u_2e0000_2efig-8">図8</a>に示すように，スイッチを通して1回転送するエネルギーは半分以下に削減可能である．ここでは，400G光トランシーバを想定しており，SerDesの消費電力が8から2pJ/bitに削減されると仮定している．なお，光トランシーバの詳細は，本小特集2「データセンター光インタコネクション技術」を御覧頂きたい．</p>
<div id="u_2e0000_2efig-7"><div class="gext fig" id="fig_7"><p><img alt="図7　様々な光トランシーバ実装方法" src="images/fig_7.png"/></p>
</div>
</div>
<div id="u_2e0000_2efig-8"><div class="gext fig" id="fig_8"><p><img alt="図8　消費電力の削減効果" src="images/fig_8.png"/></p>
</div>
</div>
<p class="line-gap"> </p>
</div>
<div class="wrapper level3" id="h_2e0000_2e4_EF_BC_8E_E3_82_B3_E3_83_B3_E3_83_94_E3_83_A5_E3_83_BC_E3_83_86_E3_82_A3_E3_83_B3_E3_82_B0_E3_82_A2_E3_83_BC_E3_82_AD_E3_83_86_E3_82_AF_E3_83_81_E3_83_A3"><h1>4．コンピューティングアーキテクチャ</h1>
<p>　多数のサーバをネットワークで接続する現状のDCでは，AI/HPCを中心としたコンピューティングシステムの処理能力の向上に限界が見えてきた．そのため，ネットワークだけでなく，サーバの領域でも新たな変革の動きが起こっている．</p>
<p class="line-gap"> </p>
<p class="lft li-1em left1em">◆AI機械学習に最適化したネットワーク</p>
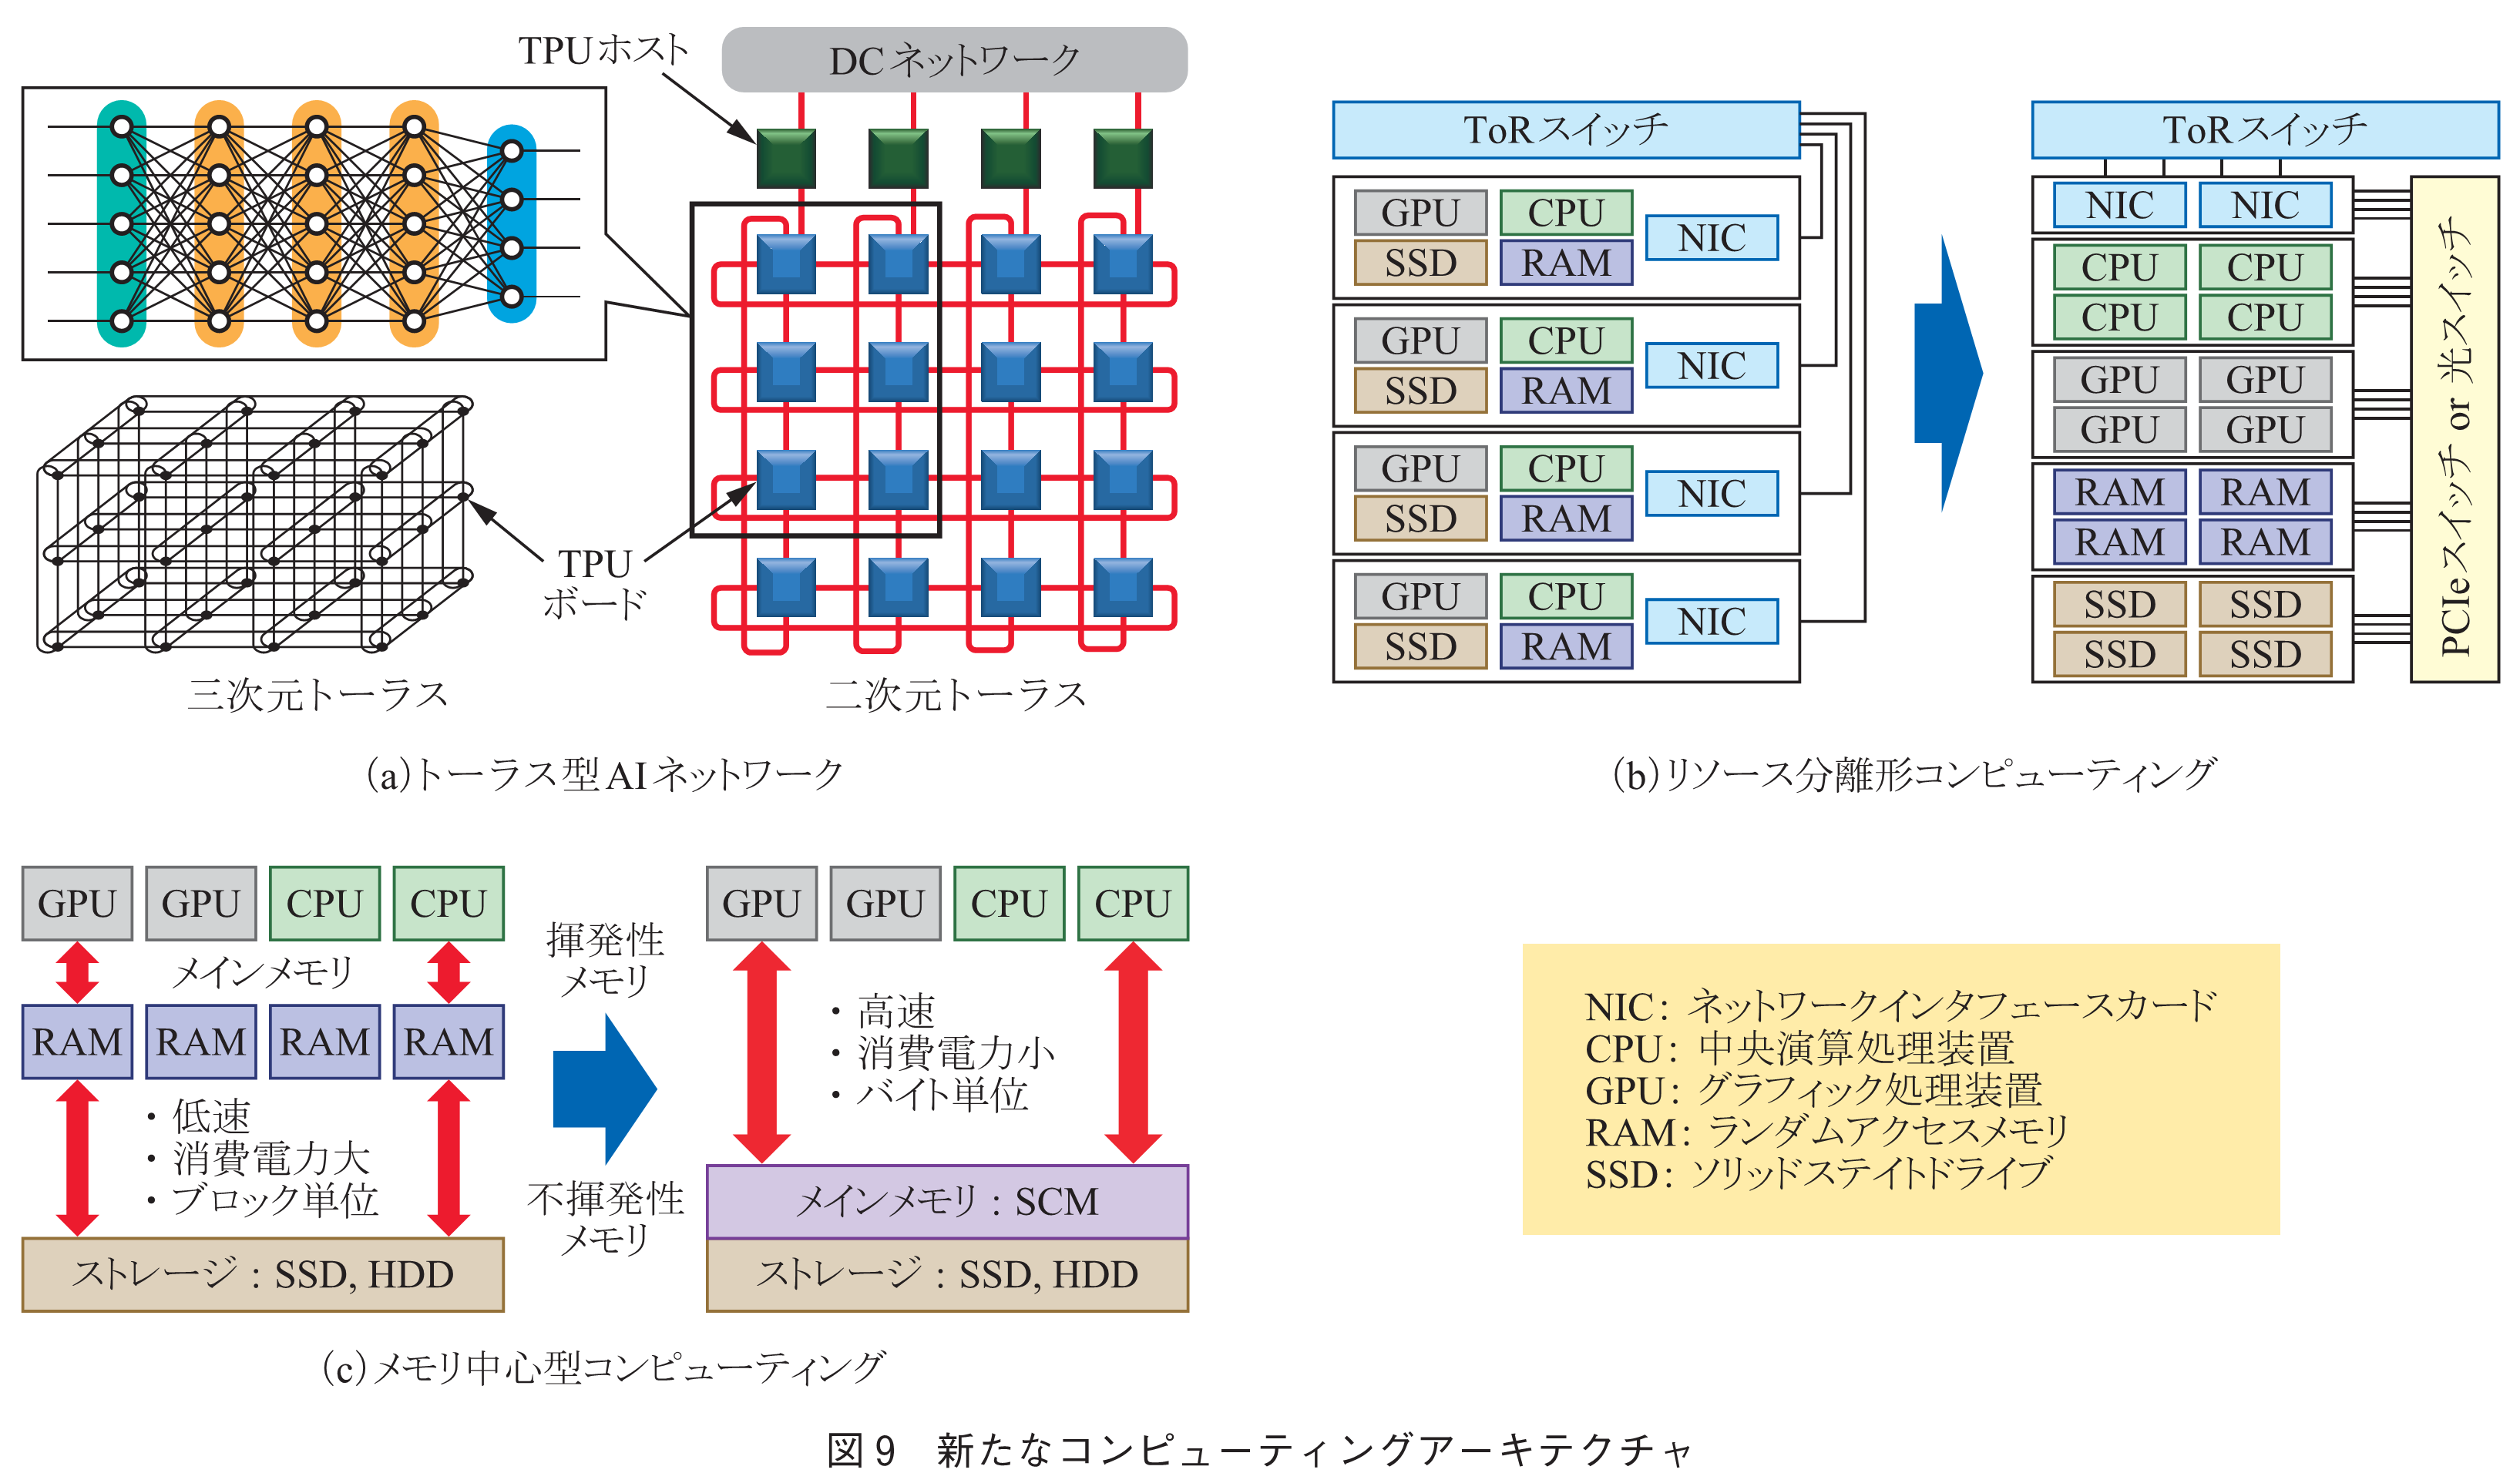
<p>　近年AIパラメータは爆発的に増大し，AI処理には100個以上のアクセラレータが用いられる．これを従来のサーバシステムで実行するとネットワーク転送遅延が大きな障害となる．<a href="index.html#u_2e0000_2efig-9">図9</a>(a)は，2021年にGoogleが発表したTPUv4の概念図である<a href="#u_2e0000_2eref13"><sup>(13)</sup></a>．1枚のTPU（Tensor Processing Unit）ボードには4個のTPUチップが搭載されており，各TPUボードはそれを制御するためのCPUを搭載したTPUホストと接続されている．各TPUボードはTPUホストを介してToRスイッチと接続されており，DCネットワークを通じて外部のストレージやサーバ等とつながっている．更にDCネットワークとは別に，TPUボード間は直接光リンクで接続されており，三次元のトーラスネットワークを構成している（以前のTPUv3では二次元トーラスを採用）．システム全体では，4,096チップのTPUチップが搭載されており，それらが部分的にニューラルネットワークを構成することで，多くのAI機械学習の並列処理を可能としている．</p>
<div id="u_2e0000_2efig-9"><div class="gext fig" id="fig_9"><p><img alt="図9　新たなコンピューティングアーキテクチャ" src="images/fig_9.png"/></p>
</div>
</div>
<p class="lft li-1em left1em">◆リソース分離形（Resource-disaggregated）コンピューティング</p>
<p>　従来のシステムでは，<a href="index.html#u_2e0000_2efig-9">図9</a>(b)左に示すように，プロセッサ，アクセラレータ，メモリ，ストレージ等のリソースがセットになったBox型サーバが多数（20～40）ラックに装備され，それぞれのサーバからは，NIC（Network Interface Card）でEtherパケット等にプロトコル変換され，DCネットワークにつながっている．このとき，使用しないリソースが多数発生するため，リソースの利用効率が低下し，エネルギー効率の悪化につながっている．</p>
<p>　<a href="index.html#u_2e0000_2efig-9">図9</a>(b)右は，リソース分離形コンピューティングの概念を示す<a href="#u_2e0000_2eref14"><sup>(14)</sup></a>．各リソースは分離され，それぞれのプール群が形成され，高速PCIeスイッチ（または光スイッチ）を介して接続される．この概念は2000年代後半頃から提案されているが，近年のAI/HPCの高度化やDMA（Direct Memory Access: CPUを介することなく他のリソースが直接メモリにアクセス可能な技術）の進歩に伴い，変革の動きが加速してきた．このリソース分離形構成のメリットとしては，</p>
<p class="line-gap"> </p>
<p class="li-1em left1em"><span class="gext width2em">・</span>アプリケーションごとに必要なリソースを割当可能</p>
<p class="li-1em left1em"><span class="gext width2em">・</span>リソース利用効率，エネルギー効率が大幅に向上</p>
<p class="li-1em left1em"><span class="gext width2em">・</span>リソースごとに拡張／縮小，アップグレードが可能</p>
<p class="line-gap"> </p>
<p>等があるが，逆にデメリットとしては，</p>
<p class="line-gap"> </p>
<p class="li-1em left1em"><span class="gext width2em">・</span>膨大なリンク数・リンク帯域が必要</p>
<p class="li-1em left1em"><span class="gext width2em">・</span>異なるリソース間（特にメモリ）での転送遅延の増大</p>
<p class="line-gap"> </p>
<p>などが懸念される．これらの問題の解決には，前述のCPO光トランシーバを用いた，チップ間の大容量・低遅延光インタコネクト技術の進展が期待されている．更に，図ではラックスケールのイメージであるが，将来はDCスケールに拡張されることが期待される．</p>
<p class="line-gap"> </p>
<p class="lft li-1em left1em">◆メモリ中心型（Memory-centric）コンピューティング</p>
<p>　現状のシステムでは，不揮発性メモリであるストレージから，個々のCPUやGPUに接続された少量の揮発性主記憶メモリ（DRAM）にデータをコピーし，処理後すぐに再びストレージに書き戻す必要がある（<a href="index.html#u_2e0000_2efig-9">図9</a>(c)左）．このとき，DRAMとストレージのアクセス速度には大きな差があり，無駄な時間が発生する．更に，データ転送には1回の計算処理よりも多くのエネルギーを消費する．また，ストレージからはブロック単位での転送しかできないため，主記憶メモリでは不要なデータも受け取る必要があるなど，多くの問題を抱えている．</p>
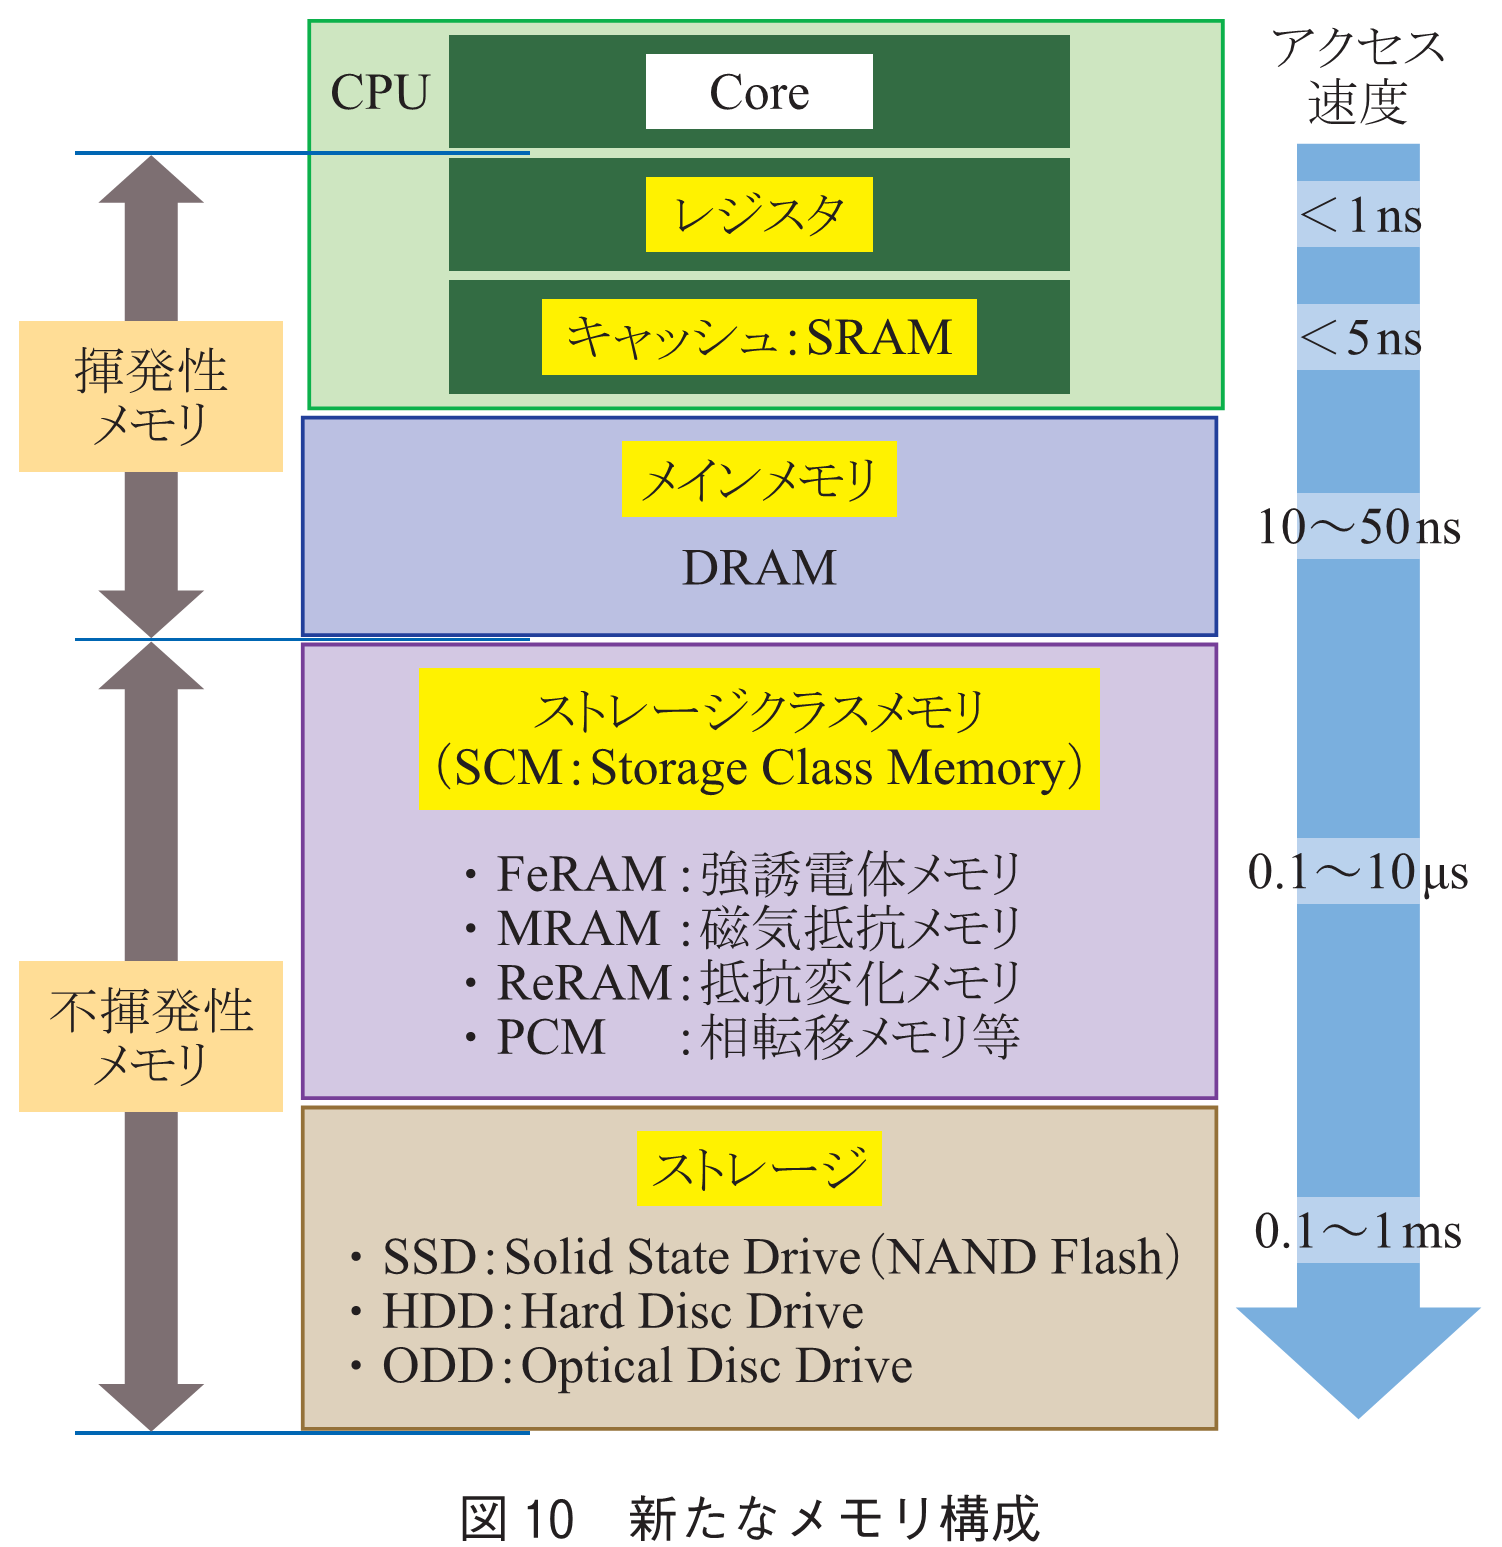
<p>　このような頻繁に発生するデータ移動を極力避けることがメモリ中心型（駆動型）コンピューティングの基本的なコンセプトであり，その1例を<a href="index.html#u_2e0000_2efig-9">図9</a>(c)右に示す<a href="#u_2e0000_2eref15"><sup>(15)</sup></a>．究極の狙いとしては，システムの中心に不揮発性の大容量主記憶メモリ（共有メモリ）を配置して，プロセッサ等を直接接続することである．これにより，処理中のストレージとのデータ移動は不要となる（ストレージは処理後のバックアップメモリ）．しかし，従来の不揮発性メモリ（SSD, HDD）は，前述のような問題があり，主記憶メモリとして用いるのは困難である．</p>
<p>　この問題の解決に向けて期待されているのが，次世代メモリと呼ばれるSCM（Storage Class Memory)<a href="#u_2e0000_2eref16"><sup>(16)</sup></a>である（<a href="index.html#u_2e0000_2efig-10">図10</a>）．SCMは，不揮発性でありながらDRAMに近い高速性を有し，更にバイト単位での細かなアクセスが可能なため，主記憶メモリとして用いることが可能である．しかし，大容量化にはまだ時間が必要であり，しばらくはDRAMとの併用が検討されている．新たなコンピューティングアーキテクチャの詳細は，本小特集3「データセンターにおけるコンピューティング技術とそれを支えるネットワーク技術の動向」を御覧頂きたい．</p>
<div id="u_2e0000_2efig-10"><div class="gext fig" id="fig_10"><p><img alt="図10　新たなメモリ構成" src="images/fig_10.png"/></p>
</div>
</div>
<p class="line-gap"> </p>
</div>
<div class="wrapper level3" id="h_2e0000_2e5_EF_BC_8E_E3_81_8A_E3_80_80_E3_82_8F_E3_80_80_E3_82_8A_E3_80_80_E3_81_AB"><h1>5．お　わ　り　に</h1>
<p>　本稿では，データセンターが直面する様々なパラダイムシフトについて概説した．近年研究開発が激化するCPO超小形光トランシーバが実現すれば，従来の「装置間の光接続」から「チップ間の光接続」に概念がシフトし，リソース分離／メモリ中心コンピューティングを大きく押し上げることが可能である．更に，これらの新たな概念の光インタコネクション技術やコンピューティングアーキテクチャは，データセンターの省電力化，大容量化，リソース利用効率／情報処理能力の向上，省スペース化等に大きく寄与する．そして，このような新たな技術をベースとしたエッジ／クラウドコンピューティングでは，Cyber-Physical Systemを高度化し，超スマート社会をもたらすことでこれまでにない新たなサービスが創造されることが期待される．超スマート社会に関しては，本小特集5「B5G/6Gにおけるエッジコンピューティングの役割と超スマート社会への展開」を御覧頂きたい．</p>
<p class="line-gap"> </p>
</div>
<div class="wrapper level3" id="h_2e0000_2e_E6_96_87_E3_80_80_E3_80_80_E3_80_80_E3_80_80_E3_80_80_E7_8C_AE"><h1>文　　　　　献</h1>
<div class="gext references"><p class="li" id="u_2e0000_2eref01"><span class="gext listmark">(１) </span>総務省，“Beyond 5G推進戦略―6Gへのロードマップ，” 2020．</p>
<p class="li" id="u_2e0000_2eref02"><span class="gext listmark">(２) </span>Cisco Global Cloud Index: Forecast and Methodology, 2016-2021.</p>
<p class="li" id="u_2e0000_2eref03"><span class="gext listmark">(３) </span>X. Zhou, R. Urata, and H. Liu, “Beyond 1Tb/s datacenter interconnect technology: challenges and solutions,” OFC2019, Tu2F.5, 2019.</p>
<p class="li" id="u_2e0000_2eref04"><span class="gext listmark">(４) </span>A. Singh, J. Ong, A. Agarwal, G. Anderson, A. Armistead, R. Bannon, S. Boving, G. Desai, B. Felderman, P. Germano, A. Kanagala, H. Liu, J. Provost, J. Simmons, E. Tanda, J. Wanderer, U. Hölzle, S. Stuart, and A. Vahdat, “Jupiter rising: A decade of clos topologies and centralized control in Google’s datacenter network,” Commun. ACM, vol.59, no.9, pp.88-97, 2016.</p>
<p class="li" id="u_2e0000_2eref05"><span class="gext listmark">(５) </span>C. Minkenberg, N. Farrington, A. Zilkie, D. Nelson, C. Lai, D. Brunina, J. Byrd, B. Chowdhuri, N. Kucharewski, K. Muth, A. Nagra, G. Rodriguez, D. Rubi, T. Schrans, P. Srinivasan, Y. Wang, C. Yeh, and A. Rickman, “Reimagining datacenter topologies with integrated silicon photonics,” J. Opt. Commun. and Netw., vol.10, no.7, pp.126-139, 2018.</p>
<p class="li" id="u_2e0000_2eref06"><span class="gext listmark">(６) </span>A. Krishnamoorthy, H. Thacker, O. Torudbakken, S. Muller, A. Srinivasan, P. Decker, H. Opheim, J. Cunningham, I. Shubin, X. Zheng, M. Dignum, K. Raj, E. Rongved, and R. Penumatcha, “From chip to cloud: Optical interconnects in engineered systems,” J. Lightwave Technol., vol.35, no.15, pp.3103-3115, 2017.</p>
<p class="li" id="u_2e0000_2eref07"><span class="gext listmark">(７) </span>F. Testa and L. Pavesi, Optical Switching in Next Generation Data Centers, Springer Verlag, New York, 2017.</p>
<p class="li" id="u_2e0000_2eref08"><span class="gext listmark">(８) </span>Y. Mori and K. Sato, “High-port-count optical circuit switches for intra-datacenter networks,” J. Opt. Commun. and Netw., vol.13, no.8, 2021.</p>
<p class="li" id="u_2e0000_2eref09"><span class="gext listmark">(９) </span>OIF CEI-224G.<br/><a class="wrap" href="https://www.oiforum.com/technical-work/hot-topics/common-electrical-i-o-cei-224g/">https://www.oiforum.com/technical-work/hot-topics/common-electrical-i-o-cei-224g/</a></p>
<p class="li" id="u_2e0000_2eref10"><span class="gext listmark">(10) </span>A. Ghiasi, “Large datacenters interconnect bottlenecks,” Opt. Express, vol.23, no.3, pp.2085-2090, 2015.</p>
<p class="li" id="u_2e0000_2eref11"><span class="gext listmark">(11) </span>高井厚志，“光トランシーバーのForm Factorの新動向(8)～CPO/NPOと新しいデータセンター” EE Times, Jan. 2022．</p>
<p class="li" id="u_2e0000_2eref12"><span class="gext listmark">(12) </span>OIF CEI-112G.<br/><a class="wrap" href="https://www.oiforum.com/technical-work/hot-topics/common-electrical-interface-cei-112g-2/">https://www.oiforum.com/technical-work/hot-topics/common-electrical-interface-cei-112g-2/</a></p>
<p class="li" id="u_2e0000_2eref13"><span class="gext listmark">(13) </span>Google Cloud.<br/><a class="wrap" href="https://cloud.google.com/tpu/docs/system-architecture-tpu-vm">https://cloud.google.com/tpu/docs/system-architecture-tpu-vm</a></p>
<p class="li" id="u_2e0000_2eref14"><span class="gext listmark">(14) </span>K. Bergman, “Deeply disaggregated computing systems with embedded photonics,” ARPA-E ENLITENED Program, 2021.<br/><a class="wrap" href="https://arpa-e.energy.gov/sites/default/files/2021-01/DAY1_Bergman_ENLITENED_Phase2_Kickoff.pdf">https://arpa-e.energy.gov/sites/default/files/2021-01/DAY1_Bergman_ENLITENED_Phase2_Kickoff.pdf</a></p>
<p class="li" id="u_2e0000_2eref15"><span class="gext listmark">(15) </span>HPE Blog, “Memory-driven computing explained,” 2017.<br/><a class="wrap" href="https://www.hpe.com/us/en/newsroom/blog-post/2017/05/memory-driven-computing-explained.html">https://www.hpe.com/us/en/newsroom/blog-post/2017/05/memory-driven-computing-explained.html</a></p>
<p class="li" id="u_2e0000_2eref16"><span class="gext listmark">(16) </span>G. Kranz, “Storge class memory (SCM),” TechTarget, Aug. 2021.<br/><a class="wrap" href="https://www.techtarget.com/searchstorage/definition/storage-class-memory">https://www.techtarget.com/searchstorage/definition/storage-class-memory</a></p>
</div>
<p class="date">（2022年8月30日受付　<span class="gext not-separates">2022年9月16日最終受付） </span></p>
<p class="line-gap"> </p>
<div class="gext authors"><div class="gext author"><div class="gext fig"><p><img alt="高橋　亮" src="images/fig_11.png"/></p>
</div>
<div class="gext author_text"><p><span class="gext author_name"><ruby>高<rp>(</rp><rt>たか</rt><rp>)</rp></ruby><ruby>橋<rp>(</rp><rt>はし</rt><rp>)</rp></ruby>　<ruby>亮<rp>(</rp><rt>りょう</rt><rp>)</rp></ruby></span><span class="gext member">（正員：シニア会員）</span></p>
<p>　昭62東大・工・電子卒．平4同大学院博士課程了．同年日本電信電話株式会社．超高速光デバイス，光信号処理，光ネットワーク，車載光通信方式等の研究に従事．現在，国立研究開発法人情報通信研究機構ネットワーク研究所総括研究員．工博．</p>
</div>
</div>
</div>
<p> </p>
</div><div class="continue-point">
	<p style="clear: both;"> </p>
	<hr/>
<p>オープンアクセス以外の記事を読みたい方は、以下のリンクより電子情報通信学会の学会誌の購読もしくは学会に入会登録することで読めるようになります。
また、会員になると豊富な豪華特典が付いてきます。</p>
    <br />
    <p><a href="https://www.journal.ieice.org/bin/pdf_link.php?fname=k106_2_98&amp;lang=J&amp;year=2023" target="_blank">続きを読む(PDF)</a>　　　<a href="https://www.ieice.org/jpn/books/backnumber.html" target="_blank">バックナンバーを購入する</a>　　　　<a href="https://www.ieice.org/jpn/join/index.html" target="_blank">入会登録</a></p>  
    <a href="https://twitter.com/share" class="twitter-share-button" data-url="https://app.journal.ieice.org/trial/106_2/k106_2_98/index.html" data-lang="ja" data-size="large" data-hashtags="IEICE">ツイート</a>　　
    <div class="fb-share-button" data-href="https://app.journal.ieice.org/trial/106_2/k106_2_98/index.html" data-layout="button" data-size="large"></div> <div id="fb-root"></div>
    <script>
        !function(d,s,id){
            var js,fjs=d.getElementsByTagName(s)[0],p=/^http:/.test(d.location)?'http':'https';
            if(!d.getElementById(id)){
                js=d.createElement(s);
                js.id=id;js.src=p+'://platform.twitter.com/widgets.js';
                fjs.parentNode.insertBefore(js,fjs);
            }
        }(document, 'script', 'twitter-wjs');
   </script> 
   <script>
       //<![CDATA[
       (function(d, s, id) {
       var js, fjs = d.getElementsByTagName(s)[0];
       if (d.getElementById(id)) return;
       js = d.createElement(s); js.id = id;
       js.src = "//connect.facebook.net/ja_JP/sdk.js#xfbml=1&version=v4.0";
       fjs.parentNode.insertBefore(js, fjs);
       }(document, 'script', 'facebook-jssdk'));
       //]]>
   </script>   <p>電子情報通信学会 - IEICE会誌はモバイルでお読みいただけます。</p>   <p><a href="https://app.journal.ieice.org/">電子情報通信学会誌 会誌アプリのお知らせ</a></p>    <p></p>    <p><b>電子情報通信学会 - IEICE会誌アプリをダウンロード</b></p>
    <p><a href="https://itunes.apple.com/jp/app/dian-zi-qing-bao-tong-xin/id957695896?mt=8"><img src="../../img/App_Store_JP.svg" style="width:165px; height:50px" /></a>　　<a href='https://play.google.com/store/apps/details?id=org.ieice.journal.app.ieice&amp;hl=ja'><img alt='Google Play で手に入れよう' src='../../img/google-play-badge_web.png' style="width:165px; height:49px" /></a></p>
        </div>
</div> 
</div> 
<div class="caution">本サイトでは会誌記事の一部を試し読み用として提供しています。</div>
</body>
</html>